为生者与死者计数
1662年,伦敦服饰用品商约翰·格朗特发表了对这座城市教区死亡记录的统计分析,这是已知最早依靠收集数据、而非个别轶闻得出一般性结论的尝试之一。比利时天文学家阿道夫·凯特勒在1830年代以他的“社会物理学”拓展了这一思路,把统计分布应用到人类特征上。弗洛伦斯·南丁格尔在1858年把这一传统带入实用说服领域,用一幅呈现克里米亚战争死亡率数据的极区图,说服英国陆军部相信,杀死大多数士兵的是恶劣的卫生条件,而非战斗本身——她也因此成为第一位当选英国皇家统计学会会士的女性。
按时间排列的节点,不是每周活动格。
格子越深,表示该主题在这项指标上越高。
低高
与“搭建AI模型”的刻板印象不同,多数工作日的时间分布在编写SQL查询和Python代码以提取并清洗数据、运行统计检验或训练模型,以及把结果转化成非技术利益相关者能够采取行动的图表或备忘录上。从业者调查一致表明,数据清洗与准备大约占用了总工作时间的一半甚至更多。
不需要。与医学或法律不同,这个领域没有执业资格证,也没有唯一必需的学位;统计学、计算机科学、数学或相关量化领域的学士或硕士学位是最常见的路径,而一份扎实的真实项目作品集,往往比具体学历更受雇主看重。博士学位在研究密集型或应用机器学习岗位中更为常见。
并不完全是。它大量借鉴统计学——费舍尔的实验设计、图基的探索性分析——但又加入了传统统计学系很少教授的编程、数据库工程与机器学习。威廉·S·克利夫兰在2001年提出这个术语,正是为了描述这个建立在统计学之上、而非取代统计学的、计算密集型的扩大版学科。
常规部分已经暴露在风险之中:AutoML工具能够拟合并调优标准模型,AI助手编写SQL查询、初稿探索性图表和样板管道代码的速度都比人快。尚未被自动化的,是构思出正确的问题、判断一个规律究竟有意义还是伪相关,以及为建立在结果之上的决策承担责任。
各国及资历差异很大。美国劳工统计局公布,2023年数据科学家这一职业的年薪中位数约为10.8万美元,初级分析师起薪往往接近7万至9.5万美元,而大型科技公司的资深或首席数据科学家算上股权的总薪酬可达20万至40万美元甚至更高。
数据分析师通常用现有数据和仪表盘回答已界定的业务问题;数据科学家构建新的统计模型和预测分析,处理的数据往往更杂乱;机器学习工程师则把模型从笔记本中取出,让它在生产环境中大规模、可靠地运行。三者的界限一直在模糊,很多人在职业生涯中会在这三者之间不断转换。
数据科学是本站最年轻的职位名称之一,却建立在最古老的技艺之上:把一堆记录变成有人可以据以行动的结论。“data scientist”这个名字大约始于2008年;其背后的学科则可以追溯三个世纪,历经统计学家们计数、检验并可视化证据的历程。
整个故事贯穿着两条线索:一条是统计推断缓慢的专业化过程,从伦敦一位店主的死亡率统计表,到费舍尔的作物试验;另一条则是把这份遗产包装成企业职位名称、学术院系,并在短暂时刻成为“21世纪最性感的工作”这一过程,速度快得多、也晚近得多。
伦敦一位服饰用品商约翰·格朗特出版了《对死亡率统计表的自然与政治观察》,系统分析了伦敦自瘟疫年代以来一直保存的每周教区死亡记录,据此估算出这座城市的人口,并识别出死因中的种种规律。这是已知最早从大批收集数据中得出一般性结论、而非依靠个别轶闻的尝试之一,也让这位没有受过大学教育的店主格朗特当选为皇家学会会员——这正是这门学科在多年之后才拥有的名字最终追溯到的思想根源。
约翰·格朗特发表了一项对伦敦教区死亡记录的统计研究,估算人口规模与死亡率规律——是已知最早系统利用收集数据得出一般性结论的尝试之一。
威廉·西利·戈塞特是都柏林健力士啤酒厂的一名统计学家,他以笔名“Student”发表了《均值的概然误差》,因为健力士禁止员工以真名发表文章,由此引入了此后一直用于小样本分析的t分布。
罗纳德·费舍尔在罗森斯特实验站分析了数十年的作物产量数据后,出版了这本确立方差分析与现代实验设计为标准统计实践的著作。
耶日·内曼与埃贡·皮尔逊的论文《论统计假设最有效检验问题》,为统计学提供了以量化误差率来判定结果是否显著的现代框架。
约翰·图基的论文《数据分析的未来》主张,分析真实数据应被承认为一门有自身方法的独立科学,而不是数理统计学的一个次要分支。
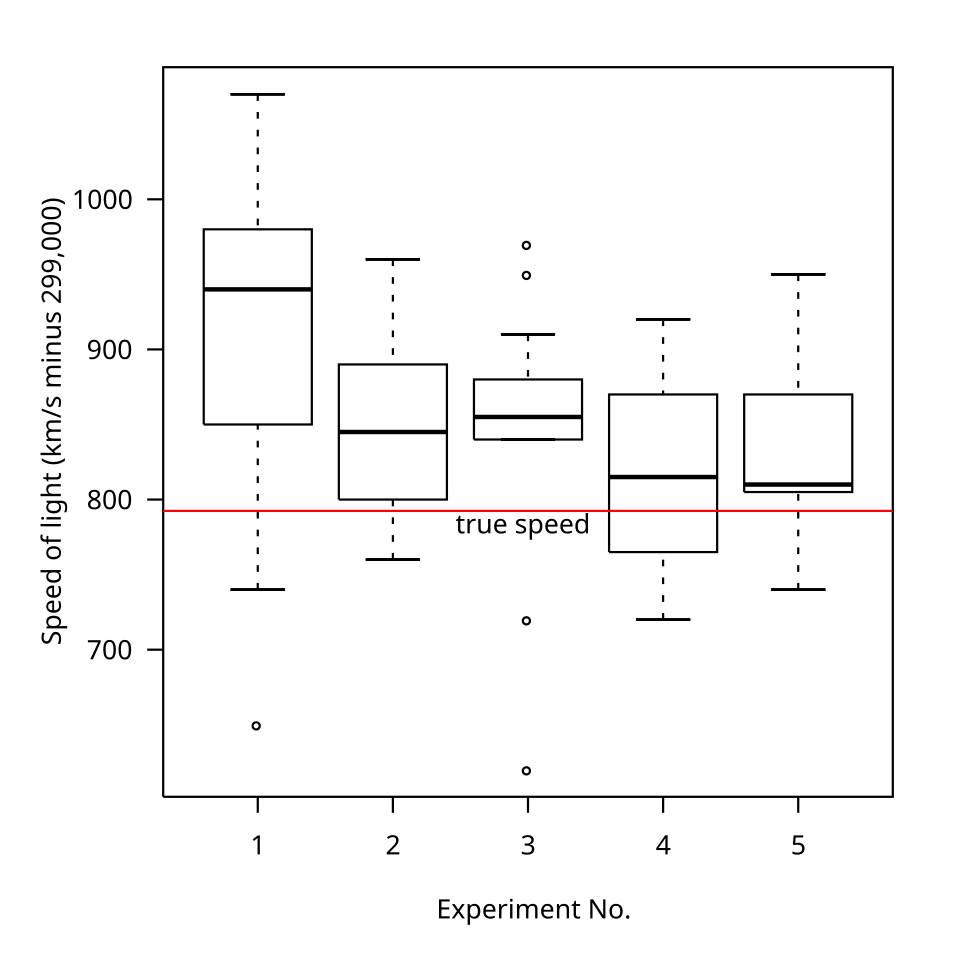
图基这本书为从业者提供了动手可用的工具——其中包括箱形图——用以在拟合任何模型之前,先用肉眼理解数据集的形态。
三人在《AI Magazine》发表的论文将“数据库中的知识发现”正式确立为围绕原始数据挖掘的更广泛过程,是1990年代把日益庞大的企业数据库中模式发现工作形式化浪潮的一部分。
贝尔实验室统计学家威廉·S·克利夫兰发表《数据科学:拓展统计学领域技术范畴的行动计划》,提议设立专门的大学数据科学院系。
分别在LinkedIn与Facebook组建数据团队的DJ·帕蒂尔与杰夫·哈默巴克,各自独立地把“data scientist”确定为其团队所做的统计加工程工作的职位名称。
托马斯·达文波特与DJ·帕蒂尔2012年10月发表的文章《数据科学家:21世纪最性感的工作》,引发了长达十年的企业招聘热潮,也带来了一波新的大学学位项目。
1662年,伦敦服饰用品商约翰·格朗特发表了对这座城市教区死亡记录的统计分析,这是已知最早依靠收集数据、而非个别轶闻得出一般性结论的尝试之一。比利时天文学家阿道夫·凯特勒在1830年代以他的“社会物理学”拓展了这一思路,把统计分布应用到人类特征上。弗洛伦斯·南丁格尔在1858年把这一传统带入实用说服领域,用一幅呈现克里米亚战争死亡率数据的极区图,说服英国陆军部相信,杀死大多数士兵的是恶劣的卫生条件,而非战斗本身——她也因此成为第一位当选英国皇家统计学会会士的女性。
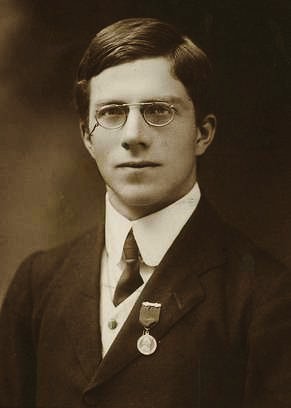
卡尔·皮尔逊1901年创办《生物统计学》期刊,为这门年轻的数理统计学科提供了一个阵地。在健力士啤酒厂担任统计学家的威廉·西利·戈塞特于1908年以笔名“Student”发表了t检验,因为健力士禁止员工以真名发表文章。罗纳德·费舍尔1925年出版的《研究工作者的统计方法》,写于他分析罗森斯特实验站数十年作物试验数据期间,引入了方差分析与严谨的实验设计。耶日·内曼与埃贡·皮尔逊在1933年以一套正式的假设检验框架完善了这套工具箱——这正是数据科学后来几乎原封不动继承下来的统计机器。
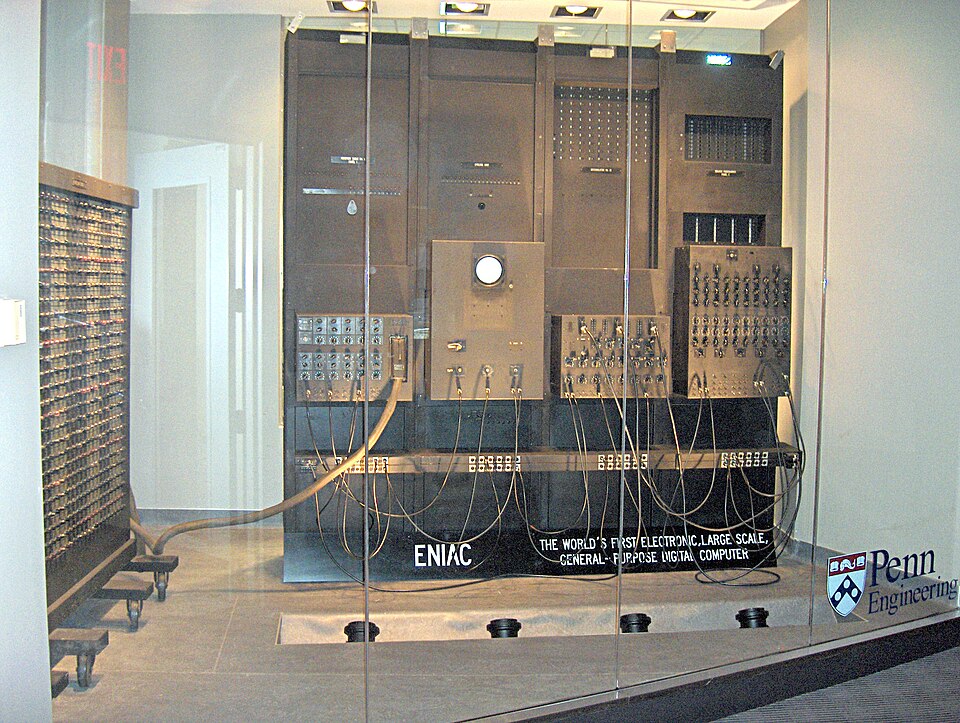
第二次世界大战加速了大规模计算,从人力计算团队一路发展到1946年问世的第一批电子通用计算机,如ENIAC。曾花数十年做手工计算的统计学家们,越来越多地借助机器在过去不可能实现的规模上运行分析。1962年,贝尔实验室兼普林斯顿统计学家约翰·图基发表《数据分析的未来》,认为把分析真实数据当作数理统计学的一个次要分支来“教得很差”是不对的,它应被承认为一门自成一体、拥有自身方法、也理应获得大学关注的科学。
图基1977年的著作《探索性数据分析》为从业者提供了动手可用的工具——其中包括箱形图——用以在拟合任何模型之前理解数据集的形态。随着企业在1980与1990年代积累起越来越庞大的交易数据库,一门与之并行的“数据挖掘”学科应运而生,用以从中发现规律;1996年,乌萨马·法亚德、格雷戈里·皮亚泰茨基-夏皮罗与帕德海克·斯迈思发表的一篇论文,正式区分了原始数据挖掘与更广泛的“数据库中知识发现”过程。顾问比尔·因蒙在这十年间的著述所推广的企业数据仓库,为这项工作在大公司内部提供了一个永久的落脚点。
贝尔实验室统计学家威廉·S·克利夫兰在2001年的一篇论文中,提议用“data science”作为一门扩大版统计学科的名字。谷歌2004年的MapReduce论文以及随后出现的开源Hadoop框架,为这个领域提供了处理互联网规模数据的廉价工具。大约在2008年,分别在LinkedIn和Facebook组建数据团队的DJ·帕蒂尔与杰夫·哈默巴克,各自独立把“data scientist”确定为职位名称,而托马斯·达文波特与帕蒂尔2012年10月发表在《哈佛商业评论》上、称其为“21世纪最性感的工作”的文章,引发了长达十年的企业招聘热潮。到2010年代末,这个角色已成熟到分裂出更专精的职位名称——分析工程师、机器学习工程师、产品分析师——与此同时,生成式AI也开始自动化那些原本这份2008年的职位说明默认由人工完成的常规查询与制图工作。
已不存在的邻近职业——被吸收、自动化或法规抹去。
早在电子计算机出现之前,一批批工作者——其中女性占比格外高,比如自1880年代起在哈佛学院天文台为恒星编目的“哈佛计算员”,以及NASA的凯瑟琳·约翰逊、多萝西·沃恩与玛丽·杰克逊,她们一直手工计算轨道轨迹到1960年代——完成了如今由软件承担的数学劳动。电子计算机在变得可靠且价格合理之后的一代人时间内,就吸纳了这一角色。
继赫尔曼·霍列瑞斯为1890年美国人口普查打造的打孔卡制表机之后,键控穿孔操作员花了数十年时间,把纸质记录誊录到大型机能够读取的卡片上,这是一项在专门培训课程中传授的文书专业技能。到1970与1980年代,直接输入的计算机终端已基本让这一角色淘汰。
企业“数据处理”部门曾雇佣程序员,通常使用COBOL语言,主要工作是编写并运行夜间定时批处理作业,好在次日早晨为管理层生成打印报表。自助式商业智能仪表盘和临时查询工具让管理者能按需自行提取数据,到2000年代几乎彻底终结了这一专业岗位。
数据科学所宣称的每一项“新”能力——从大型数据集中发现规律、严谨的推断、有说服力的可视化——都能追溯到一个具体、可查证的先驱:格朗特的死亡率统计表、费舍尔的作物试验、图基的箱形图。2001年与2008年真正改变的,主要是名字与包装,套在了一门被廉价存储与计算力重新赋能的古老手艺上。
随之而来的2012年“最性感的工作”热潮,其实已经部分走完了它的历程:这个职位名称已分裂成分析工程师、机器学习工程师与产品分析师,生成式AI正在吸纳那些2008年最初职位说明理所当然默认由人工完成的常规查询与制图工作。而这门学科真正的核心——判断数据中的一个规律究竟意味着什么——看起来仍将再一次比某个具体的职位名称活得更久。
不限同一领域,六项评分最接近的职业。
账簿的守护者:这门手艺古老到几乎发明了文字本身,如今却在与为自动化它而造的软件谈判。
抗AI 35 🗺️决定公司接下来该做什么、为什么要做——把顾客需求、商业目标和工程限制,整合成一份没有其他人能完全独自拥有的共同计划。
抗AI 50 💻写作,测试和维护了管理现代生活的代码——也是最早观看AI将自己的日常工作自动化的职业之一.
抗AI 35 📣创造需求的专业人士——从庞贝古城墙上的广告、宝洁1931年那份品牌经理备忘录,到数字时代由竞价驱动的信息流。
抗AI 38 📦构建用于训练、部署、监控和治理生产环境中机器学习模型的系统。
抗AI 54 🔎研究人们如何使用产品,将观察到的行为、需求和挫折转化为团队可以设计的证据。
抗AI 69衍生并测试关于物质,能量,空间和时间的数学定律,从一个孤独的粉笔板到3000个作者的粒子对流器纸.
抗AI 65 🧬研究生命本身的科学家,从Linnaeus手工命名物种,到用CRISPR编辑基因组,仍然在针对一个活生物体测试每一种想法.
抗AI 64 🧪亲手制造并测量物质本身的科学家——从塔普提在巴比伦蒸馏香水的年代到今天的机器人实验室,仍是那个判断谱图意味着什么的人。
抗AI 70 🔭丈量宇宙的科学家,从巴比伦泥板到空间望远镜,始终要判断数据中的哪一次闪烁是一项发现。
抗AI 70 🧮从巴比伦文士到菲尔兹奖得主,再到AI辅助证明:这门职业把难题一个定理接一个定理地变成永恒的确定性。
抗AI 70 🧿构建、测量和控制利用量子态进行计算、传感、通信和材料研究的设备。
抗AI 78 🧫使用临床、试验和卫生系统数据生成可靠的证据,以实现更安全的护理、研究和运营决策。
抗AI 68