Détecte des régularités et construit des modèles prédictifs à partir de données — un intitulé de poste né en 2008, fondé sur trois siècles de comptage, de tests et de visualisation des preuves.
Also called: Scientifique appliqué · Scientifique en apprentissage automatique
Scientifique des données : Détecte des régularités et construit des modèles prédictifs à partir de données — un intitulé de poste né en 2008, fondé sur trois siècles de comptage, de tests et de visualisation des preuves.
Un scientifique des données extrait des régularités, des prédictions et des recommandations à partir de données en combinant statistiques, programmation et connaissance du domaine, puis transforme le résultat en quelque chose qu'une entreprise, une administration ou une équipe de recherche peut exploiter. Le travail va de l'écriture de requêtes SQL pour extraire des données d'un entrepôt à leur nettoyage et leur remaniement, en passant par l'ajustement d'un modèle statistique ou d'apprentissage automatique, et l'explication de ce que le résultat permet — ou non — de conclure.
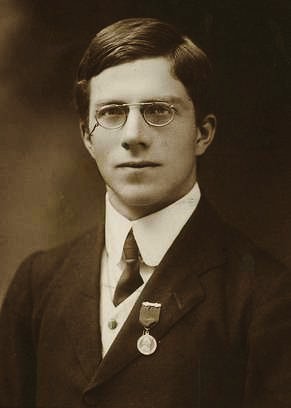
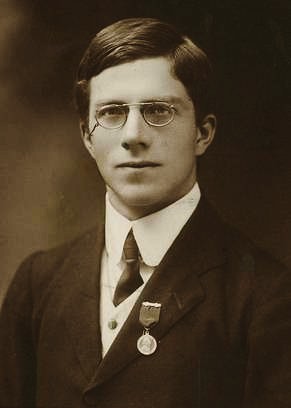
L'intitulé de poste est bien plus jeune que le métier qui le sous-tend. « Data scientist » remonte à environ 2008, lorsque DJ Patil et Jeff Hammerbacher l'adoptent indépendamment en constituant des équipes data chez LinkedIn et Facebook, tandis que le statisticien William S. Cleveland ne propose « data science » comme discipline académique qu'en 2001. La discipline sous-jacente est bien plus ancienne : elle remonte à la promotion par John Tukey, dans les années 1960-1970, de l'analyse exploratoire des données, puis aux statistiques de Ronald Fisher dans les années 1920 et à l'étude de 1662 de John Graunt sur les registres de mortalité londoniens.
Un article de 2012 de la Harvard Business Review le qualifiant de « sexiest job of the 21st century » déclenche une décennie de recrutement massif en entreprise et des centaines de nouveaux programmes universitaires. Cette vague s'est depuis mûrie : le généraliste s'est scindé en ingénierie analytique, ingénierie de l'apprentissage automatique et analytique produit, et les outils d'IA prennent en charge une part croissante des requêtes, du nettoyage et des graphiques que le poste original supposait faits à la main.
Au cœur du métier
La science des données est l’art de transformer des enregistrements imparfaits en décisions. Le plus dur n’est rarement d’ajuster un modèle ; c’est de décider ce que les données peuvent honnêtement soutenir.
La plupart du jour est un travail de preuve
Les data scientists interrogent des entrepôts, réconcilient des définitions, inspectent des distributions, nettoient des champs cassés et expliquent l’incertitude. La modélisation compte, mais un résultat n’inspire confiance que si sa lignée de données, ses hypothèses et ses alternatives peuvent être examinées. Les plus solides savent dire à un décideur qu’un graphique d’apparence sûre répond à la mauvaise question, ou qu’une association observée n’est pas une preuve de cause. Cette franchise, plus qu’un AUC élevé, évite à l’organisation de décider cher sur du sable mouvant.
Le titre cache plusieurs carrières
Un data scientist produit peut concevoir des expériences et mesurer des features. Un applied scientist peut développer des modèles prédictifs. Un decision scientist peut se concentrer sur les opérations, la finance ou la politique. Dans les organisations matures, analytics engineering, data engineering et ML engineering absorbent des parts de l’ancien rôle généraliste. La connaissance du domaine change le travail autant que la stack : une expérience sur une app marchande n’est pas une étude de résultats cliniques ni de fraude. Le même titre peut signifier SQL et tableaux de bord ici, et papers de ranking ailleurs.
La porte, c’est le raisonnement démontré
Statistique, informatique, mathématiques, économie et sciences physiques offrent des voies. Un diplôme aide, mais un entretien ou un portfolio testent souvent SQL, raisonnement statistique, qualité des données et communication plus directement. Un projet crédible n’a pas besoin d’un modèle spectaculaire : une question claire, des données documentées, une baseline adaptée et des conclusions calibrées sur la preuve. Qui ne montre qu’un notebook brillant sans limites échoue souvent quand le métier demande : « peut-on agir là-dessus ? ».
L’IA comprime l’analyse de routine
Les assistants peuvent rédiger SQL, graphiques, résumés et modèles de base. Cela change vraiment le travail d’entrée. Ils ne règlent pas les définitions de mesure, ne révèlent pas un facteur confondant caché, ne choisissent pas un usage éthique d’une prédiction et n’assument pas la responsabilité d’une décision. La profession se déplace vers le cadrage du problème, l’expérimentation, le raisonnement causal et la revue d’analyses générées par machine. Sur le marché francophone, qui unit domaine métier local et rigueur quantitative reste rare et recherché.
Comment le travail se ramifie
Cinq formes courantes du même titre — spécialité, cadre ou parcours.
Produits numériques
Data scientist produit
Utilise métriques et expériences pour guider les choix produit, en se défendant de l’optimisation trompeuse à court terme.
Systèmes prédictifs
Applied / machine-learning scientist
Construit et évalue des modèles de ranking, prévision, détection ou personnalisation, souvent avec des ingénieurs ML.
Opérations et stratégie
Decision scientist
Combine données et contexte métier ou politique publique pour soutenir planification, allocation et risque.
Growth et inférence causale
Spécialiste en expérimentation
Conçoit des tests contrôlés et quasi-expériences qui distinguent une intervention d’une corrélation.
Science et recherche publique
Data scientist recherche
Travaille sur des données observationnelles ou expérimentales complexes où reproductibilité et rigueur méthodologique l’emportent sur le shipping rapide.
Comment ça se lit selon le pays
Même métier, autres filtres, statut et rythme — réécrit pour les lecteurs de chaque langue.
Titres spécialisés et entretiens
Tech, finance et santé utilisent le titre différemment ; le recrutement teste souvent SQL, expériences et communication de façon explicite. Les hautes rémunérations se concentrent dans peu de villes et d’employeurs.
Plateformes, commerce et données d’entreprise
Grandes plateformes grand public, télécoms et conglomérats soutiennent le travail analytique ; le contexte coréen est souvent vital pour données produit et clients. Les titres peuvent mélanger analyste et scientist.
Données d’entreprise et adoption prudente
Industrie, finance et consommation élargissent l’analytics tout en maintenant des pratiques de gouvernance établies. Les équipes internationales valorisent anglais et cloud avec la connaissance du domaine local.
Vie privée et contexte industriel
Protection des données et représentation des salariés conditionnent ce qui peut être collecté et utilisé. Automobile, industrie et recherche demandent des profils qui relient statistique et opérations réelles.
Finance londonienne et recherche
Finance, conseil et produit se concentrent à Londres ; la recherche publique et les universités offrent d’autres incitations. Les rôles en contrat restent visibles sur le marché.
Finance régionale et plateformes
Banques, tech publique et sièges régionaux créent des rôles de données couvrant plusieurs marchés. Attentes réglementaires et règles de données transfrontières sont des contraintes fréquentes.
Depuis les archives
Images Commons CC/PD auto-hébergées pour cette profession.
Pourquoi l'attitude compte dans ce métier
Un modèle peut être statistiquement correct et pourtant induire un décideur en erreur ; que le data scientist le dise avant l'échéance, pas seulement quand on le lui demande, est là où l'attitude prime sur la technique.
Rapporter le résultat qui dérange la feuille de route
Une analyse qui dit qu'une fonctionnalité que tout le monde veut livrer ne bouge pas la métrique espérée, ou qu'un canal de croissance adoré ne fait que capter une demande déjà existante, est mal accueillie et facile à adoucir. Les data scientists qui rapportent quand même le résultat gênant sont la raison pour laquelle les décisions d'une entreprise suivent la réalité ; ceux qui infléchissent un résultat vers ce que la direction veut entendre transforment l'analytique en décoration.
Avouer les limites d'un petit échantillon
Une expérience de cinq jours ou une cohorte réduite peut produire un chiffre qui a l'air précis et n'est en réalité que du bruit, et presque personne en aval ne vérifiera la taille de l'échantillon avant d'agir sur ce chiffre. L'attitude qui distingue un analyste digne de confiance est de refuser qu'un chiffre paraisse plus certain que les données sous-jacentes ne le sont réellement, même quand un chiffre assuré est celui qu'une partie prenante veut.
Assumer la conséquence réelle d'un modèle
Un modèle qui refuse un prêt, classe un CV ou signale un patient fait quelque chose à une personne qui ne verra jamais le notebook dont il vient. Parce que l'auteur du modèle est généralement le seul en position de remarquer un biais subtil ou une variable qui fuit avant le déploiement, prendre cette responsabilité au sérieux — plutôt que de traiter le modèle comme le problème de quelqu'un d'autre une fois livré — est là où le préjudice est réellement rattrapé.
Des postures qui tiennent sous pression
Cinq attitudes concrètes que le métier récompense, pas des slogans.
Trace les données brutes avant de toucher à un modèle
Examine distributions, valeurs aberrantes et données manquantes de ses propres yeux avant d'ajuster quoi que ce soit, sur l'hypothèse qu'un modèle absorbera silencieusement tout ce qui est cassé dans les données plutôt que de le signaler à quiconque.
Énonce l'incertitude dans la même phrase que le résultat
Rapporte un intervalle de confiance ou une réserve à côté d'un chiffre phare plutôt que seulement une fois contesté, pour qu'une partie prenante ne puisse pas confondre une estimation approximative avec une mesure précise simplement parce que l'incertitude est restée tue.
Cherche le facteur confondant avant de célébrer un résultat
Traite une corrélation surprenante et d'apparence commode comme un problème à investiguer plutôt qu'un résultat à présenter aussitôt, parce que plus une découverte flatte le plan préféré de l'équipe, plus elle mérite d'être examinée avec soin et scepticisme.
Abandonne sa propre analyse fétiche quand les données ne tiennent pas
Abandonne une hypothèse favorite dès que les preuves cessent clairement de la soutenir, plutôt que de relancer une nouvelle coupe des données en espérant un résultat qui finirait par survivre au test, et le dit sans détour dans le compte-rendu final.
Dit que les données ne peuvent pas répondre à la question posée
Dit clairement à une partie prenante que les données disponibles ne peuvent pas soutenir une réponse assurée, plutôt que de produire un chiffre quand même simplement parce qu'un chiffre était demandé et qu'une diapositive vide semblait inacceptable à présenter.
Les moments qui le révèlent
Des situations qui séparent le discours de CV de la pratique réelle.
L'expérience qui montre que la fonctionnalité privilégiée ne fonctionne pas
La direction a déjà annoncé la date de lancement avant la fin du test A/B. Les résultats ne montrent aucun véritable gain. Que l'analyste le rapporte clairement, ou trouve une métrique secondaire qui a l'air meilleure, révèle ce qu'est réellement le métier.
Un modèle performe bien jusqu'à rencontrer un sous-groupe non testé
La précision globale paraît solide, mais une répartition par démographie ou région révèle que le modèle échoue de façon disproportionnée pour un groupe. Le remarquer avant le déploiement, sans qu'on le demande, distingue les analystes qui vérifient de ceux qui rapportent la moyenne et passent à autre chose.
Un client veut un chiffre plus précis que ce que les données permettent
Un jeu de données de trois semaines se voit demander de justifier une projection de croissance annuelle ferme. Livrer un chiffre d'apparence assurée est facile et bien accueilli ; expliquer pourquoi les données ne peuvent soutenir qu'une fourchette approximative est plus difficile et bien moins populaire.
Le tableau de bord auquel tout le monde fait confiance est discrètement faux
Une métrique largement utilisée a un bug subtil qui fait paraître la performance meilleure qu'elle n'est réellement, et personne en amont ne s'est jamais plaint. Le signaler, c'est admettre une erreur et décevoir des gens qui aimaient sincèrement l'ancien chiffre.
Là où la "vocation" devient nocive
La "culture data-driven" comme couverture de réponses prédéterminées
Les entreprises qui se présentent comme rigoureusement pilotées par la donnée utilisent parfois ce discours pour pousser les analystes à trouver un soutien pour une décision déjà prise, traitant celui qui rapporte un résultat gênant comme un mauvais joueur d'équipe. L'engouement initial du métier comme poste glamour a aussi normalisé des heures supplémentaires déguisées en curiosité — rester jusqu'à minuit pour une coupe de plus se voit loué comme de la passion, jamais questionné comme charge de travail, un schéma que le forfait-jours facilite en France en masquant le décompte des heures.
The profile
Resists AI38
Pay74
Barrier to entry55
Autonomy60
Demand78
Impact66
How exposed is it to AI?
Élevé
Une part significative du travail routinier en science des données — requêtes SQL, graphiques exploratoires, ajustement d'un modèle standard avec AutoML, rédaction de code de pipeline passe-partout — est déjà automatisable ou assistée par IA aujourd'hui, et cette part croît rapidement. Ce qui résiste à l'automatisation, c'est formuler un problème métier ambigu en question testable, juger si un résultat est réel ou un artefact statistique, et être responsable lorsqu'une décision fondée sur un modèle s'avère erronée dans le monde réel.
Que fait concrètement un scientifique des données au quotidien ?
Contrairement à l'image du « constructeur de modèles d'IA », la plupart des journées se partagent entre l'écriture de requêtes SQL et de code Python pour extraire et nettoyer les données, l'exécution de tests statistiques ou l'entraînement de modèles, et la traduction des résultats en graphique ou note de synthèse qu'un décideur non technique peut exploiter. Les enquêtes auprès des praticiens placent régulièrement le nettoyage et la préparation des données à environ la moitié — voire davantage — du temps de travail total.
Faut-il un doctorat pour devenir scientifique des données ?
Non. Contrairement à la médecine ou au droit, il n'existe ni licence ni diplôme unique obligatoire ; une licence ou un master en statistiques, informatique, mathématiques ou dans un autre domaine quantitatif voisin constitue la voie la plus courante, et un solide portfolio de projets réels compte souvent davantage aux yeux des employeurs que le diplôme exact. Les doctorats sont plus fréquents dans les rôles fortement orientés recherche ou apprentissage automatique appliqué.
La science des données n'est-elle que des statistiques sous un autre nom ?
Pas tout à fait. Elle s'appuie fortement sur les statistiques — le plan d'expérience de Fisher, l'analyse exploratoire de Tukey — mais ajoute la programmation, l'ingénierie des bases de données et l'apprentissage automatique que les départements de statistique classiques enseignaient rarement. William S. Cleveland a proposé le terme en 2001 précisément pour décrire cette version élargie et informatisée du domaine, bâtie sur les statistiques plutôt qu'en les remplaçant.
La science des données est-elle menacée par l'IA ?
L'extrémité routinière est déjà exposée : les outils AutoML peuvent ajuster et optimiser des modèles standards, et les assistants IA rédigent des requêtes SQL, des premiers graphiques exploratoires et du code de pipeline plus vite qu'un humain. Ce qui n'a pas été automatisé, c'est la formulation de la bonne question, le jugement sur le caractère significatif ou artificiel d'une régularité, et la responsabilité d'une décision fondée sur le résultat.
Combien gagnent les scientifiques des données ?
Cela varie fortement selon le pays et l'ancienneté. Le Bureau of Labor Statistics américain a fixé le salaire annuel médian de la profession « Data Scientists » à environ 108 000 $ en 2023, tandis que les analystes juniors débutent souvent entre 70 000 et 95 000 $ et que les scientifiques des données seniors ou principaux dans les grandes entreprises technologiques peuvent percevoir 200 000 à 400 000 $ ou plus en rémunération totale avec actions.
Quelle différence entre un scientifique des données, un analyste de données et un ingénieur en apprentissage automatique ?
Un analyste de données répond généralement à des questions métier définies avec des données et des tableaux de bord existants ; un scientifique des données construit de nouveaux modèles statistiques et analyses prédictives, souvent à partir de données plus désordonnées ; un ingénieur en apprentissage automatique sort un modèle du notebook et le fait tourner de façon fiable, à grande échelle, en production. Les frontières se brouillent constamment, et beaucoup passent d'un rôle à l'autre au fil d'une carrière.
Quels outils et langages de programmation utilise la science des données ?
Python domine, généralement avec des bibliothèques comme pandas et scikit-learn, aux côtés de SQL pour interroger les bases de données. R reste courant en milieu académique et en biostatistique. Les notebooks Jupyter sont l'environnement standard pour l'exploration, et les entrepôts de données cloud tels que Snowflake, BigQuery ou Databricks hébergent désormais la plupart des données que les scientifiques des données interrogent réellement.
Pourquoi « data scientist » a-t-il été qualifié de « sexiest job of the 21st century » ?
Thomas Davenport et DJ Patil ont utilisé cette formule comme titre de leur article d'octobre 2012 dans la Harvard Business Review, arguant que la combinaison rare de compétences statistiques, de capacité de codage et de jugement métier exigée par le rôle le rendait à la fois rare et très recherché. L'expression est restée, contribuant à déclencher une décennie de recrutement massif en entreprise et des dizaines de nouveaux diplômes universitaires.
Intégrer ce classement
Collez ce code sur votre blog ou site — le classement reste à jour.