Conçoit et teste les algorithmes derrière l'intelligence artificielle, dans un domaine qui s'efforce désormais d'automatiser une part croissante de son propre processus de recherche.
Also called: Chercheur en apprentissage automatique · Scientifique en IA
Chercheur en IA : Conçoit et teste les algorithmes derrière l'intelligence artificielle, dans un domaine qui s'efforce désormais d'automatiser une part croissante de son propre processus de recherche.
~19 % (Amérique du Nord)Les femmes dans les nouveaux doctorats en IA
Un chercheur en IA conçoit, entraîne et évalue les algorithmes qui permettent aux logiciels de reconnaître des images, de générer du langage, de planifier et de prendre des décisions — généralement via l'apprentissage automatique, où un modèle s'améliore à une tâche en traitant de grandes quantités de données plutôt qu'en suivant des règles écrites à la main. Le travail s'étend des laboratoires universitaires qui inventent de nouvelles architectures aux groupes de recherche d'entreprise qui mettent à l'échelle celles qui ont fait leurs preuves, en passant par des spécialistes qui consacrent toute une carrière à une tranche étroite — par exemple comment un modèle apprend à partir de très peu de données.
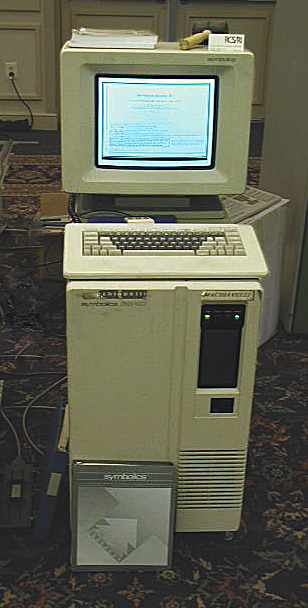
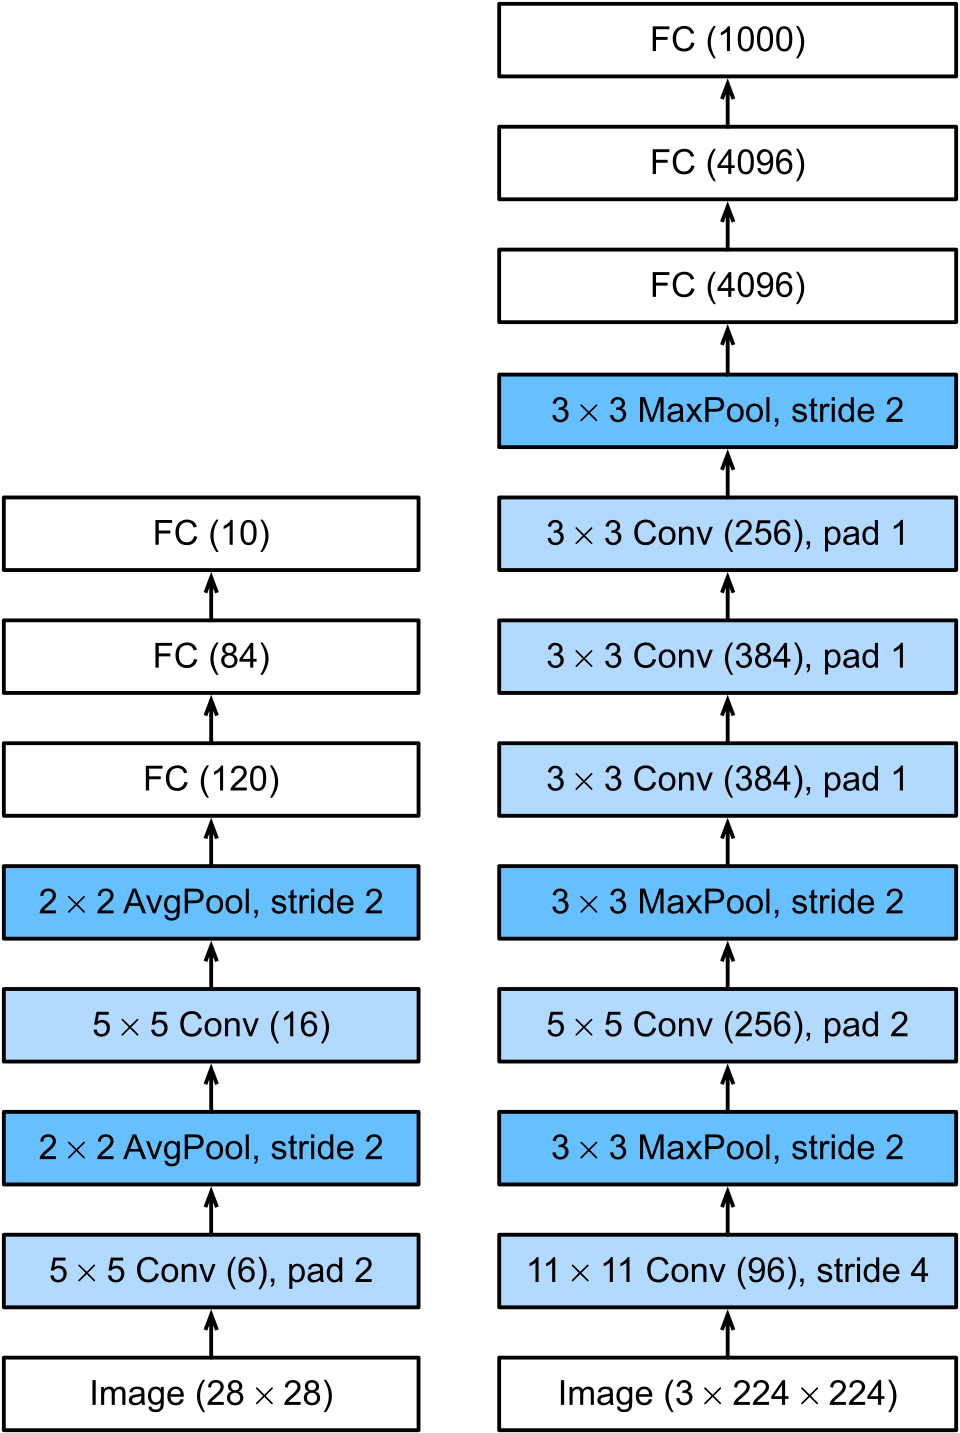
Le domaine est plus récent que la plupart des gens ne le pensent : l'expression « intelligence artificielle » a été inventée en 1955 pour un atelier d'été de 1956 au Dartmouth College, et le travail a connu deux cycles d'expansion et d'« hiver » depuis lors – des périodes où le financement s'est effondré après que les premières promesses n'aient pas été tenues. L'approche dominante d'aujourd'hui, l'apprentissage profond, a passé des décennies en position minoritaire avant qu'un seul concours de reconnaissance d'images de 2012 et qu'un article de 2017 sur « l'attention » ne remodèlent l'ensemble de la discipline autour de réseaux neuronaux de plus en plus vastes, entraînés sur toujours plus de données.
La recherche en IA est atypique parmi les métiers de ce site, car son sujet et son instrument sont la même technologie. Les outils construits à partir des propres résultats du domaine rédigent désormais des analyses de la littérature, proposent des expériences et écrivent du code pour les entraînements ; quelques laboratoires tentent ouvertement d'automatiser certaines parties du processus de recherche lui-même. Ce qui survit à cette pression, et ce qui ne survit pas, est la question à laquelle le reste de ce profil tente de répondre honnêtement plutôt que de manière rassurante.
Au cœur du métier
La recherche en IA est une discipline de surprises contrôlées : proposer une idée est facile ; montrer qu’un résultat est réel, utile et non un artefact de données, de calcul ou d’une graine chanceuse, c’est le vrai travail — entre laboratoires académiques, Inria, CNRS et équipes industrielles.
La journée, ce sont des expériences
On lit des articles, on conçoit des comparaisons, on écrit et débogue du code d’entraînement, on inspecte des runs ratés et on explique les résultats aux collaborateurs. Une amélioration prometteuse peut disparaître avec de meilleures baselines, plus de graines aléatoires ou un jeu d’évaluation différent. Le métier, c’est la rigueur expérimentale : isoler la cause d’un effet, documenter les échecs et aligner les affirmations d’un papier sur les preuves, pas sur le récit le plus séduisant. Sans cette discipline, la publication devient du storytelling technique.
Des institutions très différentes
À l’université ou dans un labo public, on poursuit des questions sur des horizons longs et on forme des doctorants ; en entreprise, on peut lancer des expériences coûteuses et pousser des résultats vers des produits ; les research engineers construisent les systèmes qui rendent l’un et l’autre possibles. Théorie, vision, langage, robotique, apprentissage par renforcement, sûreté et IA scientifique demandent des méthodes distinctes. La monnaie commune reste un résultat que d’autres peuvent inspecter, reproduire ou prolonger — pas seulement un intitulé de poste sur LinkedIn.
La publication comme filtre informel
Un doctorat demeure la voie habituelle vers la recherche indépendante, sur un socle de mathématiques, de programmation et d’un laboratoire d’accueil — souvent via Grandes écoles, masters recherche et écoles doctorales. Mais le vrai filtre pratique est un dossier de travail soigné : articles, code, jeux de données, benchmarks et collaborations qui survivent à une relecture sceptique. De solides ingénieurs ou des profils venus de la physique, des neurosciences ou de la statistique peuvent entrer par des résidences et l’open source ; les rôles de frontière exigent toutefois une profondeur de recherche démontrée.
Le champ automatise son propre flux
Les outils d’IA résument désormais la littérature, ébauchent du code d’expérience et cherchent des hyperparamètres ; certains tentent de plus larges pans de la boucle de recherche. Ils rendent le plausible moins cher à produire. Cela augmente la valeur du goût scientifique, de l’évaluation et de la responsabilité : choisir la question qui compte, détecter un défaut discret et signer une affirmation publique. L’automatisation change le rapport entre lancer des expériences et les juger, pas l’obligation de vérifier — surtout quand un résultat guide un produit ou une politique.
Comment le travail se ramifie
Cinq formes courantes du même titre — spécialité, cadre ou parcours.
Universités et laboratoires industriels
Chercheur ou chercheuse scientifique
Porte ou fait avancer un agenda de recherche par expériences, publications et collaborations.
Labs modèles et systèmes
Research engineer
Construit les chaînes d’entraînement, d’évaluation et de données qui rendent les idées testables à grande échelle.
Évaluation et gouvernance
Chercheur en sûreté / alignement de l’IA
Étudie défaillances, mésusage, robustesse et méthodes pour des comportements plus sûrs ou mieux gouvernés.
Systèmes physiques
Chercheur en robotique / IA incarnée
Combine perception, contrôle, simulation et essais matériels pour des systèmes qui agissent dans le monde réel.
Domaines scientifiques et ingénierie
Chercheur en ML scientifique
Applique ou développe des méthodes d’apprentissage pour la biologie, le climat, les matériaux, la physique et d’autres champs.
Comment ça se lit selon le pays
Même métier, autres filtres, statut et rythme — réécrit pour les lecteurs de chaque langue.
États-Unis — labs de frontière et universités
Une concentration dense de grands laboratoires, de cloud et d’universités crée des opportunités bien payées mais sélectives. L’accès au calcul et un réseau de publication solide déterminent souvent quelles questions sont réalistes.
Corée du Sud — recherche appliquée et plateformes
Centres de R&D d’entreprise, universités et groupes d’électronique soutiennent langage, vision, robotique et puces. La pression produit rapproche souvent les chercheurs du déploiement.
Japon — robotique, industrie et instituts
Robotique, manufacture et instituts de recherche établis ouvrent des parcours distinctifs. La collaboration entre labs d’entreprise et universités reste centrale.
Allemagne — instituts et science appliquée
Groupes universitaires, instituts de recherche et employeurs industriels soutiennent l’IA avec des liens forts vers la manufacture et l’ingénierie. Les financements récompensent souvent les projets collaboratifs.
Royaume-Uni — clusters et attention politique
Recherche universitaire et labs londoniens forment un écosystème concentré, aux côtés de communautés visibles sur la sûreté et les politiques publiques. La concurrence pour les profils seniors est intense.
Singapour — hub de recherche international
Universités, programmes publics et labs de multinationales recrutent à l’international. Applications régionales, données multilingues et collaborations transfrontalières sont des thèmes récurrents.
Depuis les archives
Images Commons CC/PD auto-hébergées pour cette profession.
Pourquoi l'attitude compte dans ce métier
La recherche en IA avance plus vite que sa propre relecture par les pairs, si bien que l'honnêteté d'un chercheur sur un résultat qui ne se reproduit pas, ou sur une ablation qui contredit son propre argument phare, est souvent le seul vrai contrôle qualité dont dispose la discipline.
La reproductibilité dépend d'une honnêteté que personne ne peut imposer
Un résultat peut sembler réel à cause d'une graine aléatoire favorable, d'une recherche d'hyperparamètres non déclarée, ou d'une base de comparaison moins soignée que la méthode proposée, et peu de laboratoires extérieurs ont la puissance de calcul pour vérifier. Le fait qu'un chercheur rapporte les tentatives échouées à côté de la réussie est une décision qu'aucun relecteur ne peut vérifier à la seule lecture de l'article. La fiabilité du savoir de la discipline se limite à la volonté des chercheurs de fragiliser leur propre meilleur résultat.
Le coût du calcul rend le jugement plus précieux que la persévérance
Un seul grand entraînement peut coûter plus que le salaire annuel d'un chercheur, si bien que la décision de la prochaine expérience à mener, et non la capacité à en lancer beaucoup rapidement, est là où réside la vraie compétence. Un chercheur incapable de s'attarder sur un résultat ambigu assez longtemps pour le comprendre avant de courir vers l'idée suivante gaspille des ressources qu'un collègue plus lent et plus rigoureux, au même budget, n'aurait pas gaspillées.
La pression concurrentielle récompense l'exagération
Les délais de publication et la compétition entre laboratoires qui se pressent pour annoncer la même capacité créent une tentation persistante de décrire une démonstration triée sur mesure comme un résultat général, ou une victoire sur un benchmark étroit comme une percée plus large. Le chercheur qui fait l'ablation ennuyeuse susceptible de fragiliser sa propre affirmation, même contre une échéance imminente, est ce qui garde les affirmations publiques du domaine vérifiables plutôt que promotionnelles.
Des postures qui tiennent sous pression
Cinq attitudes concrètes que le métier récompense, pas des slogans.
Faire l'ablation qui pourrait fragiliser le résultat phare
Tester si une méthode proposée surpasse réellement une base de comparaison correctement ajustée, même quand éviter cette comparaison laisserait un chiffre plus impressionnant atteindre le résumé de l'article sans contestation, et rapporter la comparaison honnêtement quel que soit le résultat.
Rapporter un résultat négatif plutôt que de le ranger discrètement
Rédiger le compte-rendu d'une expérience qui n'a pas fonctionné, y compris dans des notes internes qui orientent la direction future d'une équipe, plutôt que de la laisser disparaître parce qu'un résultat positif est plus facile à présenter et à célébrer.
Admettre qu'un résultat ne se reproduit pas
Reconnaître publiquement ou en interne quand une autre équipe, ou sa propre tentative ultérieure, ne parvient pas à reproduire un résultat déjà publié, plutôt que d'attribuer l'écart à une différence d'implémentation non précisée et de passer à autre chose.
Refuser de surestimer les capacités sous pression de soumission
Décrire ce qu'un système fait réellement dans le résumé d'un article et dans la communication publique, même quand une affirmation plus large et plus spectaculaire serait plus facile à faire accepter, financer ou couvrir favorablement par la presse et les réseaux sociaux.
Lire les journaux d'échec avant de relancer avec une nouvelle graine
Chercher pourquoi un entraînement a sous-performé, en lisant les journaux ligne par ligne, plutôt que de relancer immédiatement avec une initialisation aléatoire différente en espérant qu'un meilleur tirage corrige discrètement un bug que personne n'a réellement diagnostiqué ni compris, au risque de le reproduire dans la prochaine série d'expériences.
Les moments qui le révèlent
Des situations qui séparent le discours de CV de la pratique réelle.
Un résultat phare qu'un collègue ne peut pas reproduire
Une autre équipe, ou un collègue interne, rapporte ne pas parvenir à reproduire le résultat central de l'article. Enquêter sérieusement sur ce signalement, plutôt que de supposer une erreur d'implémentation de leur côté, est là où se voit le véritable engagement d'un chercheur envers la rigueur.
Un relecteur demande l'ablation précisément évitée
La relecture par les pairs demande exactement la comparaison qui, si elle était honnêtement faite, pourrait affaiblir l'affirmation centrale de l'article. La mener correctement et rapporter le résultat tel qu'il est trouvé, plutôt que trouver une raison technique de refuser, distingue les chercheurs rigoureux des chercheurs persuasifs.
Une démonstration publique construite à partir des meilleures tentatives parmi de nombreux échecs
Une démonstration soignée est assemblée à partir de la poignée de résultats réussis parmi des dizaines d'échecs. La façon dont ce processus de sélection est décrit publiquement — comme une capacité représentative ou, honnêtement, comme un cas trié — est un test précis et récurrent dans un domaine qui communique beaucoup par démonstration.
Une échéance de conférence arrive avant que les vérifications ne soient terminées
Une échéance de soumission majeure approche et plusieurs étapes de vérification restent inachevées. Soumettre en sautant ces vérifications, contre retarder ou nuancer les affirmations en conséquence, révèle si la pression du délai ou la rigueur scientifique dicte le comportement réel du chercheur.
Là où la "vocation" devient nocive
Le rythme effréné des délais habillé en mission
Les programmes de doctorat en machine learning et les laboratoires industriels ont documenté des cultures de nuits blanches avant les échéances, souvent décrites comme un rite de passage attendu, pas comme le symptôme d'un sous-effectif. Les jeunes chercheurs rapportent une pression de leurs directeurs pour accepter des arrangements de coauteurs ou des horaires qu'ils refuseraient autrement, justifiés par le caractère prétendument révolutionnaire du travail. En France, cette dynamique se retrouve dans les laboratoires du CNRS comme dans les grandes écoles, où le statut précaire du doctorant limite sa capacité à négocier ses conditions.
The profile
Resists AI50
Pay90
Barrier to entry92
Autonomy68
Demand90
Impact96
How exposed is it to AI?
Modéré
Une part significative du travail de routine d'un chercheur en IA (triage de la littérature, première ébauche de code d'expérimentation, recherche d'hyperparamètres, rédaction d'une section de travail connexe) est déjà relativement rapide pour un système d'IA, et les systèmes de recherche multi-agents construits explicitement pour automatiser une plus grande partie de la boucle sont un projet actif dans plusieurs grands laboratoires. Ce qui n’a pas été automatisé, c’est juger si un résultat est réel, décider quelle question mérite d’être posée et être responsable lorsqu’une affirmation publiée s’avère fausse.
Que fait réellement un chercheur en IA au quotidien ?
La plupart des journées sont consacrées à la lecture d'articles récents, à l'écriture et au débogage du code d'entraînement, à l'attente et à l'analyse des résultats d'expériences de longue durée et à la discussion des résultats avec des collaborateurs. Contrairement à l'image populaire, une grande partie du travail consiste à diagnostiquer pourquoi un modèle est moins performant ou pourquoi un résultat ne se reproduit pas, et non à réfléchir à de nouvelles architectures à partir de zéro.
Ai-je besoin d’un doctorat pour devenir chercheur en IA ?
Pour un rôle de recherche indépendant dans une université ou dans un laboratoire industriel de premier plan, effectivement oui : un doctorat reste le véritable diplôme du domaine, puisqu'il n'y a pas d'examen de licence. Les ingénieurs solides sans diplôme entrent de plus en plus dans le cadre de programmes de résidence dans l'industrie ou d'un dossier public de travaux open source et de prépublications citées, mais des titres comme « chercheur » sont toujours fortement orientés vers les titulaires de doctorat.
La recherche sur l’IA elle-même est-elle menacée par l’IA ?
Certaines parties le sont clairement : les résumés de la littérature, le code d'expérimentation passe-partout et les premières ébauches de sections de travaux connexes sont déjà régulièrement assistés par l'IA, et les laboratoires expérimentent ouvertement des systèmes qui proposent et exécutent leurs propres expériences. Il s’est avéré beaucoup plus difficile de définir ce que signifie réellement un résultat et d’assumer la responsabilité d’une affirmation publiée.
Combien gagnent les chercheurs en IA ?
Cela varie énormément selon l'employeur et l'ancienneté. La médiane américaine pour la catégorie plus large des « chercheurs en informatique et en information » était de 140 910 $ en 2024, mais les nouveaux docteurs rejoignant le laboratoire de recherche d'une grande entreprise technologique commencent souvent bien au-dessus, et un petit nombre de chercheurs seniors dans des laboratoires d'IA de pointe se seraient vu proposer des rémunérations globales d'une valeur de sept ou huit chiffres lors du concours d'embauche 2024-2025.
Quelle est la différence entre un chercheur en IA et un ingénieur en apprentissage automatique ?
Les frontières se brouillent constamment, mais une distinction grossière s'impose : le résultat d'un chercheur est généralement un article, une nouvelle méthode ou un aperçu des raisons pour lesquelles quelque chose fonctionne, jugé par des pairs ; la production d'un ingénieur est généralement un système fonctionnel en production, jugé selon sa mise en production et sa fiabilité dans des conditions réelles d'utilisation. Beaucoup de gens font les deux au cours de leur carrière.
Quels langages et outils de programmation la recherche en IA utilise-t-elle ?
Python domine, associé à un cadre logiciel d'apprentissage profond : PyTorch est désormais le plus courant dans la recherche, JAX étant populaire pour les travaux à grande échelle et affiliés à Google. Au-delà du code, les chercheurs dépendent de clusters de calcul GPU ou TPU partagés, d'outils de suivi des expériences tels que Weights & Biases et arXiv, où la plupart des nouveaux résultats circulent sous forme de prépublications des mois avant une évaluation formelle par les pairs.
Peut-on devenir chercheur en IA sans formation en informatique ?
Oui, plus facilement que dans la plupart des domaines techniques. La physique, les mathématiques, les neurosciences et les statistiques alimentent toutes directement la recherche sur l’IA, et certaines personnalités influentes – dont le physicien John Hopfield, dont le modèle de réseau neuronal de 1982 a partagé le prix Nobel de physique 2024 – sont venues d’ailleurs dans ce domaine. Une base quantitative et programmatique solide compte plus que la majeure spécifique.
Quel est aujourd’hui le plus gros goulot d’étranglement dans la recherche sur l’IA ?
De plus en plus, ce sont la puissance de calcul et l'argent pour la payer, et non les idées. La formation d'un modèle de pointe peut coûter des dizaines de millions de dollars rien qu'en calcul, concentrant la recherche la plus gourmande en ressources dans une poignée de laboratoires bien financés et poussant les chercheurs universitaires et de petits laboratoires vers des méthodes plus efficaces en matière de données et de calcul, presque par nécessité.
Intégrer ce classement
Collez ce code sur votre blog ou site — le classement reste à jour.