Diseña y prueba los algoritmos detrás de la inteligencia de máquina, en un campo que ahora corre a automatizar una parte creciente de su propio proceso de investigación.
También llamado: Investigador en aprendizaje automático · Científico de IA
Investigador en IA: Diseña y prueba los algoritmos detrás de la inteligencia de máquina, en un campo que ahora corre a automatizar una parte creciente de su propio proceso de investigación.
~19% (Norteamérica)Mujeres en nuevos doctorados de IA
Un investigador en IA diseña, entrena y evalúa los algoritmos que permiten al software reconocer imágenes, generar lenguaje, planificar y tomar decisiones — normalmente una forma de aprendizaje automático, en la que un modelo mejora en una tarea procesando grandes cantidades de datos en lugar de seguir reglas escritas a mano por una persona. El trabajo abarca laboratorios universitarios que inventan nuevas arquitecturas, grupos de investigación corporativos que escalan las ya probadas, y especialistas que dedican una carrera a una franja estrecha, como cómo aprende un modelo a partir de muy pocos datos.
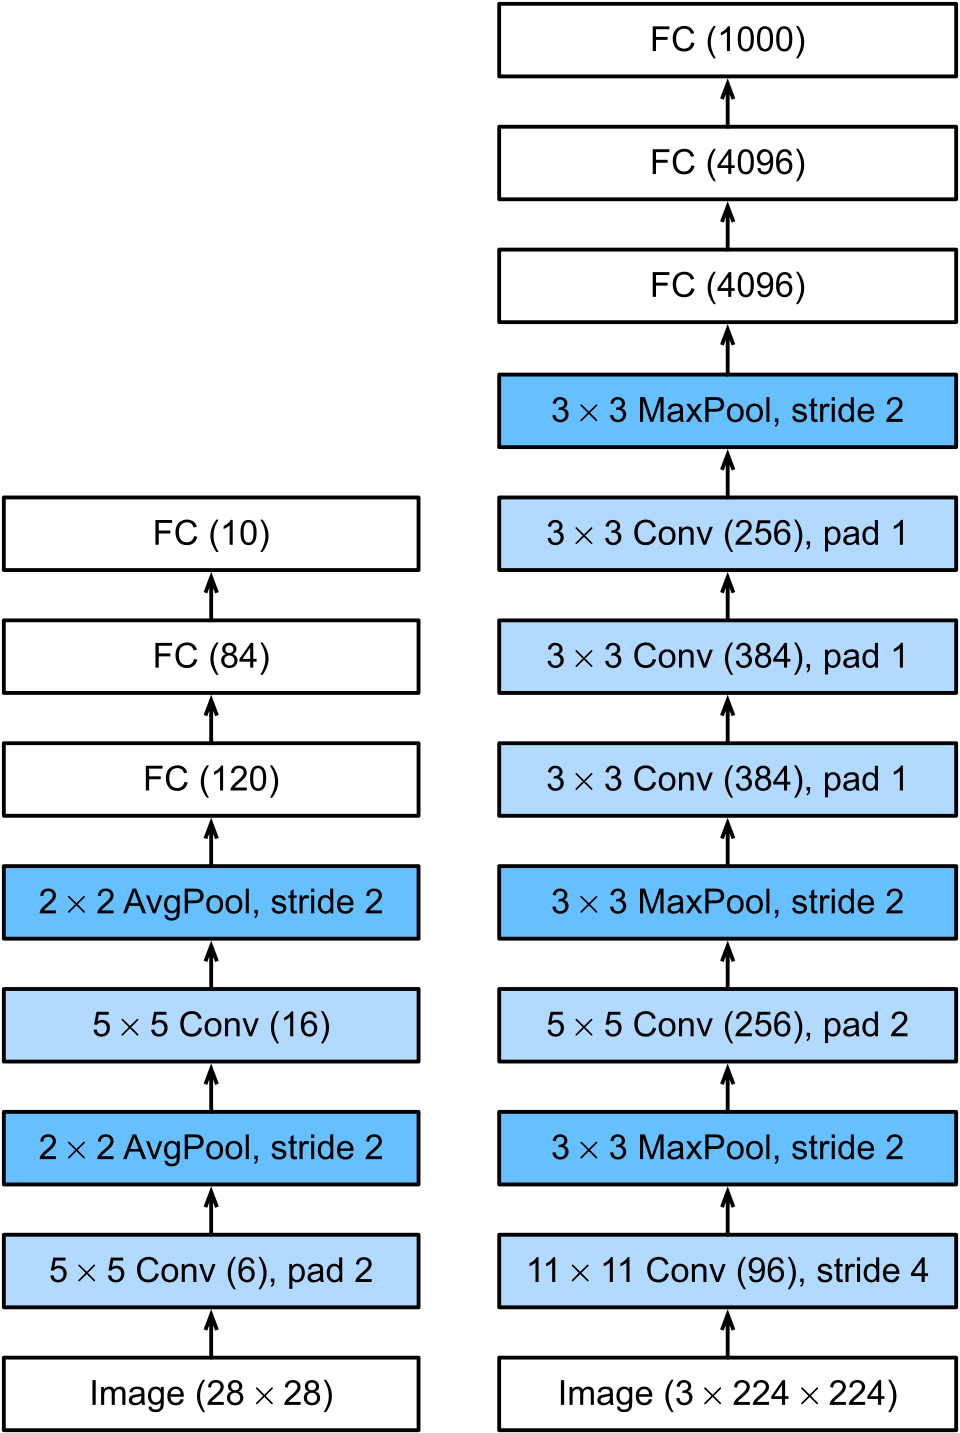
El campo es más joven de lo que la mayoría asume: la expresión «inteligencia artificial» se acuñó en 1955 para un taller de verano de 1956 en Dartmouth College, y desde entonces el trabajo ha pasado dos veces por auge e «invierno» — periodos en los que la financiación se derrumbó tras incumplirse las primeras promesas. El enfoque dominante de hoy, el aprendizaje profundo, pasó décadas como posición minoritaria antes de que un concurso de reconocimiento de imágenes en 2012 y un artículo de 2017 sobre «atención» reordenaran toda la disciplina en torno a redes neuronales cada vez más grandes entrenadas con cada vez más datos.
La investigación en IA es inusual entre las profesiones de este sitio porque su objeto y su instrumento son la misma tecnología. Herramientas construidas a partir de la propia producción del campo ya redactan revisiones de literatura, proponen experimentos y escriben código para ejecuciones de entrenamiento, y unos pocos laboratorios intentan abiertamente automatizar partes del propio proceso de investigación. Qué sobrevive a esa presión, y qué no, es la pregunta que el resto de este perfil intenta responder con honestidad más que con tranquilidad.
Dentro de la profesión
La investigación en IA es una disciplina de sorpresas controladas: proponer una idea es fácil; demostrar que un resultado es real, útil y no un artefacto del dato, del cómputo o de una semilla afortunada es el trabajo de verdad.
El día son experimentos, no inspiración
El investigador lee papers, diseña comparaciones, escribe y depura código de entrenamiento, inspecciona corridas fallidas y explica resultados a colaboradores. Una mejora prometedora puede evaporarse tras baselines más fuertes, más semillas aleatorias o un conjunto de evaluación distinto. El oficio es rigor experimental: aislar qué causó el efecto, documentar resultados negativos y alinear las afirmaciones del paper con la evidencia, no con la narrativa más atractiva. En laboratorios de Barcelona, Madrid, Ciudad de México o Buenos Aires, el cuello de botella suele ser el mismo: tiempo de GPU y criterio para no sobreinterpretar una curva.
El trabajo atraviesa instituciones distintas
En la universidad se persiguen preguntas de horizonte largo y se forman estudiantes; en labs industriales se corren experimentos costosos y se llevan resultados a producto; los research engineers construyen los sistemas que hacen posible lo uno o lo otro. Teoría, visión, lenguaje, robótica, aprendizaje por refuerzo, seguridad e IA científica exigen métodos distintos. La moneda compartida es un resultado que otros puedan inspeccionar, reproducir o extender —no solo un cargo—. En el mundo hispanohablante conviven grupos académicos fuertes, hubs de producto y un flujo constante de talento hacia EE. UU. y Europa del Norte.
La publicación es la puerta informal
El doctorado sigue siendo la vía habitual hacia investigación independiente, apoyada en matemáticas, programación y el laboratorio de un director. Pero la puerta práctica es un historial de trabajo cuidadoso: papers, código, datasets, benchmarks y colaboraciones que sobrevivan a revisión escéptica. Ingenieros fuertes y perfiles de física, neurociencia o estadística pueden entrar por residencias y aportaciones open source, aunque los roles de frontera suelen exigir profundidad investigadora demostrada. Un portfolio con abstracciones limpia y resultados negativos honestos pesa más que un título sin evidencia.
El campo automatiza su propio flujo
Las herramientas de IA ya resumen literatura, borran código experimental y buscan hiperparámetros; algunos sistemas intentan trozos mayores del bucle de investigación. Pueden abaratar el trabajo plausible. Eso eleva el valor del gusto investigador, la evaluación y la responsabilidad: decidir qué pregunta importa, detectar un fallo silencioso y respaldar una afirmación pública. La automatización cambia la proporción entre correr experimentos y juzgarlos, no la obligación de verificar. Quien solo produce borradores sin criterio de evaluación se vuelve intercambiable con más rapidez.
Cómo se ramifica el trabajo
Cinco formas habituales del mismo título: especialidad, entorno o trayectoria.
Universidades y labs industriales
Científico investigador
Define o avanza una agenda de investigación mediante experimentos, papers y colaboraciones.
Labs de modelos y sistemas
Research engineer
Construye entrenamiento, evaluación y datos para que las ideas de investigación sean comprobables a escala.
Alineación y evaluación
Investigador en seguridad / alineación de IA
Estudia fallos de modelo, uso indebido, robustez y métodos para un comportamiento o gobernanza más seguros.
Sistemas físicos
Investigador en robótica / IA encarnada
Combina percepción, control, simulación y experimentos hardware para sistemas que actúan en el mundo.
Ciencia e ingeniería de dominio
Investigador en ML científico
Aplica o desarrolla métodos de aprendizaje para biología, clima, materiales, física u otros campos.
Cómo se lee en cada país
El mismo oficio cambia de puerta, estatus y textura diaria — reescrito para lectores de cada idioma.
Labs de frontera y universidades
Una concentración densa de grandes labs, cómputo en la nube y universidades crea oportunidades bien pagadas pero selectivas. El acceso al cómputo y a una red de publicación fuerte puede decidir qué preguntas son factibles.
Investigación aplicada y grandes plataformas
En Corea del Sur, centros de I+D corporativos, universidades y empresas de electrónica impulsan trabajo en lenguaje, visión, robótica y chips. La presión de producto acerca al investigador al despliegue: no es raro que un paper y un feature de servicio compartan el mismo trimestre, con métricas de negocio tan presentes como las de benchmark.
Robótica, industria e institutos
La robótica, la manufactura y los institutos de investigación consolidados crean vías distintivas. La colaboración entre labs corporativos y universidades sigue siendo importante; el ritmo puede ser más paciente que en hubs de modelo generativo puro.
Institutos y ciencia aplicada
Grupos universitarios, institutos de investigación y empleadores industriales sostienen la investigación en IA con vínculos fuertes a manufactura e ingeniería. Las estructuras de financiación suelen premiar proyectos colaborativos y consorcios.
Clusters de investigación y atención política
La investigación universitaria y los labs con base en Londres concentran el ecosistema, junto a comunidades visibles de seguridad de IA y política pública. La competencia por talento senior es intensa.
Hub de investigación internacional
Universidades, programas públicos de investigación y labs multinacionales reclutan a escala internacional. Aplicaciones regionales, datos multilingües y colaboración transfronteriza son temas habituales.
Del archivo
Imágenes Commons CC/PD autoalojadas para esta profesión.
Por qué la actitud importa en este oficio
La investigación en inteligencia artificial avanza más rápido que su propia revisión por pares, así que la honestidad de un investigador sobre un resultado que no replica o una ablación que desmonta su propio titular es, con frecuencia, el único control de calidad real que tiene el campo.
La reproducibilidad depende de una honestidad que nadie puede imponer
Un resultado puede parecer real por una semilla aleatoria afortunada, una búsqueda de hiperparámetros no declarada o una base de comparación menos afinada que el método propuesto, y pocos laboratorios externos tienen el cómputo para comprobarlo. Que un investigador informe de las semillas fallidas junto a la exitosa es una decisión que ningún revisor puede verificar solo con el artículo. El conocimiento del campo es tan fiable como la disposición de los investigadores a debilitar su propio mejor resultado.
El coste del cómputo hace que el criterio valga más que la persistencia
Un solo entrenamiento a gran escala puede costar más que el salario anual de un investigador, así que la decisión de qué experimento ejecutar a continuación —no la capacidad de lanzar muchos experimentos con rapidez— es donde realmente reside la habilidad. Un investigador que no sabe sentarse con un resultado ambiguo el tiempo necesario para entenderlo, antes de perseguir la siguiente idea llamativa, malgasta recursos que un colega más lento y cuidadoso, con el mismo presupuesto, no desperdiciaría.
La presión competitiva recompensa exagerar
Los plazos de publicación y la carrera entre laboratorios por anunciar la misma capacidad crean una tentación constante de describir una demo cuidadosamente elegida como un resultado general, o una victoria en un benchmark estrecho como un avance más amplio. El investigador que ejecuta la aburrida ablación que podría desmontar su propia afirmación, incluso con un plazo encima, es lo que mantiene comprobables las afirmaciones públicas del campo en vez de meramente promocionales.
Posturas que resisten bajo presión
Cinco actitudes concretas que el trabajo recompensa, no eslóganes.
Ejecuta la ablación que podría desmontar el titular
Comprueba si un método propuesto supera realmente a una base bien afinada, incluso cuando saltarse esa comparación permitiría un número más impresionante en el resumen del artículo, e informa del resultado con honestidad sea el que sea.
Publica un resultado negativo en vez de archivarlo en silencio
Escribe un experimento que no funcionó, incluido en notas internas que orientan la dirección futura de un equipo, en lugar de dejar que desaparezca porque un resultado positivo es más fácil de presentar y celebrar.
Admite cuando un resultado no replica
Reconoce, en público o internamente, cuando otro equipo, o su propio intento posterior, no logra reproducir un hallazgo publicado antes, en lugar de atribuir la discrepancia a una diferencia de implementación sin especificar y pasar página.
Se niega a exagerar capacidades bajo presión de envío
Describe lo que un sistema realmente hace en el resumen del artículo y en las comunicaciones públicas, aunque una afirmación más amplia y llamativa fuera más fácil de aceptar, financiar o cubrir favorablemente en prensa y redes sociales.
Lee los registros del fallo antes de relanzar con otra semilla
Investiga por qué un entrenamiento rindió por debajo de lo esperado en vez de reintentar de inmediato con otra inicialización aleatoria, con la esperanza de que una tirada de dados mejor arregle un fallo que nadie diagnosticó ni entendió de verdad.
Momentos que lo revelan
Situaciones que separan el lenguaje de currículum de la práctica real.
Un resultado destacado que un colega no logra reproducir
Otro equipo, o un colega interno, informa de que no puede replicar el resultado central de un artículo. Investigar ese aviso con seriedad, en vez de asumir un error de implementación por su parte, es donde se ve el compromiso real de un investigador con la corrección.
Un revisor pide justo la ablación que se evitó
La revisión por pares pide exactamente la comparación que, ejecutada con honestidad, podría debilitar la afirmación central del artículo. Hacerla bien e informar del resultado tal cual, en vez de encontrar una excusa técnica para no hacerla, separa a los investigadores rigurosos de los persuasivos.
Una demo pública montada con lo mejor de muchos intentos fallidos
Una demostración pulida se compone con el puñado de resultados buenos entre docenas de fallos. Cómo se describe públicamente ese proceso de selección —como capacidad representativa o, con honestidad, como el mejor caso escogido— es una prueba concreta y recurrente en un campo que comunica sobre todo mediante demos.
Un plazo de congreso llega antes que las comprobaciones
Se acerca un plazo importante de envío y quedan pasos de verificación sin terminar. Enviar con las comprobaciones saltadas, frente a retrasar o matizar las afirmaciones en consecuencia, revela si manda la presión del plazo o el estándar científico en el comportamiento real del investigador.
Dónde la "vocación" se vuelve dañina
El agobio del plazo disfrazado de misión
Los programas de doctorado en aprendizaje automático y los laboratorios de la industria han documentado culturas de trabajo nocturno antes de cada plazo, descritas a menudo como un rito de paso esperado y no como un síntoma de falta de personal. En universidades de España y de varios países latinoamericanos, becarios de doctorado con estipendios muy por debajo del coste de vida sostienen buena parte de esta investigación bajo la promesa de una futura plaza académica escasa. Investigadores junior reportan presión de sus directores para aceptar acuerdos de autoría u horarios que de otro modo rechazarían, justificados por lo supuestamente transformador del trabajo. El mismo lenguaje de «cambiar el mundo» desincentiva cuestionar horarios insostenibles.
El perfil
Resiste a la IA50
Sueldo90
Barrera de entrada92
Autonomía68
Demanda90
Impacto96
¿Cuán expuesto está a la IA?
Moderado
Una parte significativa del trabajo rutinario de un investigador en IA — triage de literatura, borradores de código de experimentos, búsqueda de hiperparámetros, redactar una sección de trabajo relacionado — ya es comparablemente rápida para un sistema de IA, y los sistemas de investigación multiagente construidos explícitamente para automatizar más del bucle son un proyecto activo en varios laboratorios importantes. Lo que no se ha automatizado es juzgar si un resultado es real, decidir qué pregunta vale la pena hacer, y rendir cuentas cuando una afirmación publicada resulta ser incorrecta.
¿Qué hace realmente un investigador en IA en el día a día?
La mayoría de los días se reparte entre leer artículos recientes, escribir y depurar código de entrenamiento, esperar y analizar resultados de experimentos largos, y discutir hallazgos con colaboradores. Contra la imagen popular, una gran parte del trabajo consiste en diagnosticar por qué un modelo rinde por debajo de lo esperado o un resultado no se replica, no en idear nuevas arquitecturas desde cero.
¿Hace falta un doctorado para ser investigador en IA?
Para un puesto de investigación independiente en una universidad o en un laboratorio industrial de primer nivel, en la práctica sí: el doctorado sigue siendo la credencial real del campo, ya que no hay examen de licencia. Ingenieros sólidos sin él entran cada vez más por programas de residencia industrial o por un historial público de trabajo de código abierto y preprints citados, pero títulos como «research scientist» siguen inclinándose con fuerza hacia quienes tienen doctorado.
¿La propia investigación en IA está en riesgo por la IA?
Partes de ella, claramente sí: el resumen de literatura, el código boilerplate de experimentos y los borradores de secciones de trabajo relacionado ya se asisten de forma rutinaria con IA, y los laboratorios experimentan abiertamente con sistemas que proponen y ejecutan sus propios experimentos. Enmarcar qué significa realmente un resultado, y asumir la responsabilidad de una afirmación publicada, ha resultado mucho más difícil de ceder.
¿Cuánto ganan los investigadores en IA?
Varía enormemente según el empleador y la antigüedad. La mediana estadounidense para la categoría más amplia de «científico de investigación informática e información» fue de $140,910 en 2024, pero los nuevos doctores que se incorporan al laboratorio de investigación de una gran tecnológica suelen empezar muy por encima, y un pequeño número de investigadores sénior en laboratorios de IA de frontera habrían recibido, según se informa, paquetes totales de siete u ocho cifras durante la competencia de contratación de 2024–2025.
¿Cuál es la diferencia entre un investigador en IA y un ingeniero de aprendizaje automático?
Las fronteras se difuminan constantemente, pero una distinción aproximada se sostiene: el producto de un investigador suele ser un artículo, un método nuevo o una intuición sobre por qué algo funciona, juzgado por la revisión por pares; el de un ingeniero suele ser un sistema en producción que funciona, juzgado por si se despliega y aguanta el uso real. Muchas personas hacen ambas cosas a lo largo de una carrera.
¿Qué lenguajes de programación y herramientas usa la investigación en IA?
Python domina, emparejado con un marco de aprendizaje profundo — PyTorch es ahora el más común en investigación, con JAX popular para trabajo a gran escala y afiliado a Google. Más allá del código, los investigadores dependen de clústeres compartidos de GPU o TPU, herramientas de seguimiento de experimentos como Weights & Biases, y arXiv, donde la mayoría de los nuevos resultados circulan como preprints meses antes de la revisión formal por pares.
¿Se puede ser investigador en IA sin formación en informática?
Sí, con más facilidad que en la mayoría de los campos técnicos. Física, matemáticas, neurociencia y estadística alimentan directamente la investigación en IA, y algunas figuras influyentes —entre ellas el físico John Hopfield, cuyo modelo de red neuronal de 1982 compartió el Premio Nobel de Física de 2024— llegaron al campo desde otras disciplinas. Una base cuantitativa y de programación sólida importa más que la carrera concreta.
¿Cuál es el mayor cuello de botella en la investigación en IA hoy?
Cada vez más, la potencia de cálculo y el dinero para pagarla, no las ideas. Entrenar un modelo de frontera puede costar decenas de millones de dólares solo en cómputo, concentrando la investigación más intensiva en recursos dentro de un puñado de laboratorios bien financiados y empujando a investigadores universitarios y de laboratorios más pequeños hacia métodos más eficientes en datos y cómputo casi por necesidad.
Insertar este ranking
Pega este código en tu blog o web; el ranking se mantiene actualizado.