谱系树是模型,不是部落族谱
每一根枝干都基于同源词集合与年代假设——假设一变,树形就变。
五条研究要点——先扫一眼再深入。
语系是民族图集的参考层:你可以核验的格局,而不是大陆的领奖台。
每一层解释度量是什么、何处会误导,以及如何在不做种族排名的情况下连接文化页面。
人口学与语言学在变化;把数字当作有时代界限的。
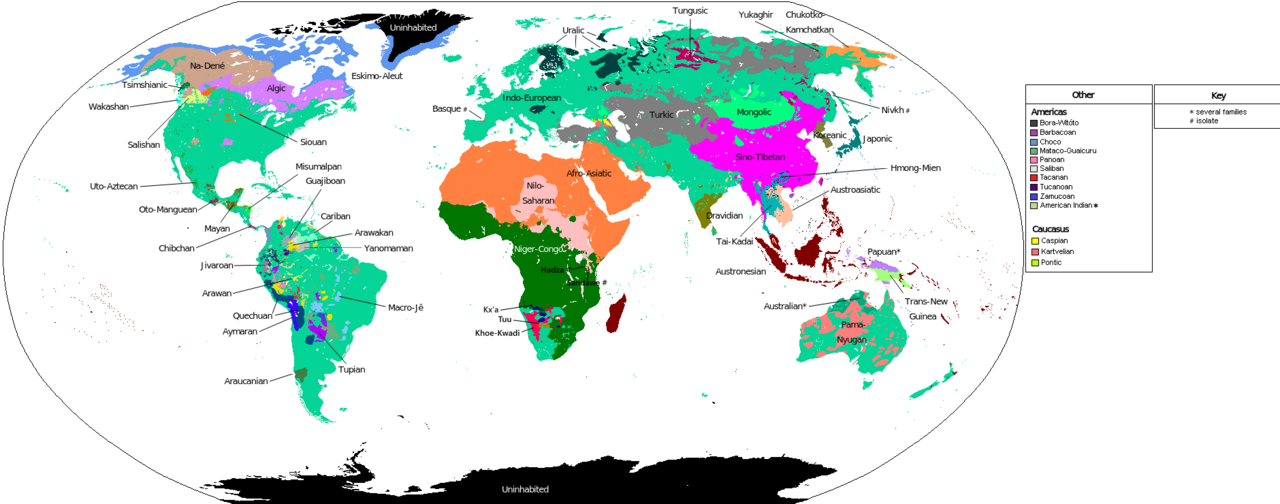
语系度量什么,以及为何重要。
这一层存在是为了回答“在哪里?”与“如何相连?”,而不滑向“谁更好?”。
把它与文化页并读:语言、城市与迁徙正是民族实际相遇的方式。
可通过系统语音对应重建共同祖先的语言——不是按说话人的长相。
少数语系覆盖巨大使用人口;其余数千种多为地方性且脆弱。
语言联盟可跨语系共享特征(巴尔干、东南亚大陆)。
英语、西班牙语、法语等叠在更古老的地图上,却并未抹去它们。
语言转换与征服之后,亲缘语言可由祖先背景迥异的人群使用。
细心读者留意的信号,以及把地图变成神话的陷阱。
每一根枝干都基于同源词集合与年代假设——假设一变,树形就变。
尼日尔—刚果语系与南岛语系的广布反映的是时间与农业扩散,与智力无关。
巴斯克语、阿伊努语等提醒我们语系也有“孤儿”——不要强行归类。
传教士语法书起的“部落”名称至今仍被地图照搬——该问问是谁命的名。
把论文与研究主题改写成好奇读者也能读懂的文字——不做种族排名。
规律的音变对应让语言学家将语言归为语系——这是一种方法,不是种族普查。
要点 同源词胜过巧合。
贝尔伍德式模型将某些扩散与农业联系起来;批评者要求逐案证明。
要点 宏大叙事需要地方性检验。
波浪模型捕捉到了纯树模型会扭曲的方言连续体——这对欧洲、印度等地都很重要。
要点 不是所有关系都是分支。
传教士语法书与殖民调查发明了后来固定在地图上的民族名称。
要点 是谁为这个语系命名的?
贝叶斯树看起来权威,但如果同源词数据不严谨,得出的历史也不可靠。
要点 漂亮的图表需要干净的数据。
书籍、综述与博物馆路线——起点,不是教学大纲。
面向初学者的主要语系概览——是方法论,不是种族普查。
语音对应与同源词——语言学家如何构建谱系树。
濒危语言世界地图展示——命名背后的政治。
田野语言学家争分夺秒记录濒死语言——紧迫但不宿命。
附有参考文献的在线目录——请核对统计与争议。
不是。图集页面拒绝优劣框架。
当母版修订时;联合国与语言数据集在移动——请核对正文中的日期。
可以,请注明 Tool-Lifes 以及正文中点名的公开数据集。
可再利用许可与稳定的维基百科标题供给我们的媒体流水线。
不。它们显示语言、密度、迁徙或方法——绝不是种族联赛表。
文化页在相关时注明冲突;图集层偏好人口学盆地而非宣传地图。
指标本身不是;用它给人类价值排名才是。
把本页与多样性支柱中的“种族不是生物学”配对阅读。