Skip to content Pular para uma secao

📊Origins & Evolution

Cientista de Dados · Encontra padrões e constrói modelos preditivos a partir de dados – um cargo de 2008 baseado em três séculos de contagem, teste e visualização de evidências.

De relance
Linha do tempo

Marcos em ordem. E historia, nao uma grelha semanal.

1662 Graunt analisa as contas de mortalidade de Londres1908 Gosset publica o teste t como 'Student'1925 Fisher publica 'Métodos Estatísticos para Pesquisadores'1933 Neyman e Pearson formalizam testes de hipóteses1962 Tukey argumenta que a análise de dados é uma ciência própria1977 A 'Análise Exploratória de Dados' de Tukey populariza o box plot1996 Fayyad, Piatetsky-Shapiro e Smyth definem 'descoberta de conhecimento'2001 Cleveland propõe 'ciência de dados' como um campo2008 Patil e Hammerbacher cunharam o cargo2012 Harvard Business Review chama-lhe o ‘trabalho mais sexy’
  1. Graunt analisa as contas de mortalidade de Londres
  2. Gosset publica o teste t como 'Student'
  3. Fisher publica 'Métodos Estatísticos para Pesquisadores'
  4. Neyman e Pearson formalizam testes de hipóteses
  5. Tukey argumenta que a análise de dados é uma ciência própria
  6. A 'Análise Exploratória de Dados' de Tukey populariza o box plot
  7. Fayyad, Piatetsky-Shapiro e Smyth definem 'descoberta de conhecimento'
  8. Cleveland propõe 'ciência de dados' como um campo
  9. Patil e Hammerbacher cunharam o cargo
  10. Harvard Business Review chama-lhe o ‘trabalho mais sexy’
Intensidade da pontuacao

Celulas mais escuras marcam uma pontuacao mais alta nesse indicador.

Ultima revisao Fontes e creditosCréditos de mídiaMetodologia

Respostas curtas

O que um cientista de dados realmente faz no dia a dia?

Ao contrário da imagem de “construção de modelos de IA”, a maioria dos dias é dividida entre escrever consultas SQL e código Python para extrair e limpar dados, executar testes estatísticos ou modelos de treinamento e traduzir os resultados em um gráfico ou memorando sobre o qual uma parte interessada não técnica possa agir. Pesquisas realizadas com profissionais colocam consistentemente a limpeza e preparação de dados em cerca de metade ou mais do tempo total de trabalho.

Você precisa de um PhD para se tornar um cientista de dados?

Não. Ao contrário da medicina ou do direito, não há licença ou diploma único exigido; um bacharelado ou mestrado em estatística, ciência da computação, matemática ou áreas quantitativas relacionadas é o caminho mais comum, e um forte portfólio de projetos reais geralmente é mais importante para os empregadores do que a credencial exata. Os PhDs são mais comuns em funções de aprendizado de máquina aplicado ou de pesquisa intensa.

A ciência de dados é apenas estatística com um novo nome?

Não exatamente. Baseia-se fortemente em estatística – o projeto experimental de Fisher, a análise exploratória de Tukey – mas acrescenta programação, engenharia de banco de dados e aprendizado de máquina que os departamentos de estatística clássica raramente ensinam. William S. Cleveland propôs o termo em 2001 especificamente para descrever esta versão ampliada e com muita computação do campo, baseada em estatísticas em vez de substituí-la.

A ciência de dados está em risco devido à IA?

O fim da rotina já está exposto: as ferramentas AutoML podem ajustar e ajustar modelos padrão, e os assistentes de IA podem escrever consultas SQL, primeiros rascunhos de gráficos exploratórios e código de pipeline clichê mais rápido do que uma pessoa. O que não foi automatizado foi formular a pergunta certa, julgar se um padrão é significativo ou espúrio e assumir a responsabilidade por uma decisão baseada no resultado.

Quanto ganham os cientistas de dados?

Varia muito de acordo com o país e a antiguidade. O Bureau of Labor Statistics dos EUA estimou o salário médio anual para a ocupação de Cientistas de Dados em cerca de 108.000 dólares em 2023, enquanto os analistas juniores muitas vezes começam perto de 70.000 a 95.000 dólares e os cientistas de dados seniores ou principais em grandes empresas de tecnologia podem ganhar entre 200.000 e 400.000 dólares ou mais em remuneração total com capital próprio.

Qual é a diferença entre um cientista de dados, um analista de dados e um engenheiro de aprendizado de máquina?

Um analista de dados normalmente responde a questões de negócios definidas com dados e painéis existentes; um cientista de dados constrói novos modelos estatísticos e análises preditivas, muitas vezes a partir de dados mais confusos; um engenheiro de aprendizado de máquina tira um modelo de um notebook e o faz funcionar de maneira confiável, em escala, na produção. Os limites se confundem constantemente e muitas pessoas alternam entre os três ao longo da carreira.

Comece por esta secao - Origins & Evolution

Abrir lab comparar

Share

Ciência de dados é um dos cargos mais jovens neste site, além de um dos ofícios mais antigos: transformar uma pilha de registros em uma reivindicação sobre a qual alguém pode agir. O nome “cientista de dados” data apenas de 2008; a disciplina subjacente remonta a três séculos de estatística contando, testando e visualizando evidências.

Dois fios permeiam toda a história: uma lenta profissionalização da inferência estatística, desde as tabelas de mortalidade de um comerciante de Londres até aos testes de colheita de Fisher, e uma embalagem muito mais rápida e mais recente dessa herança num cargo empresarial, num departamento académico e, brevemente, no “emprego mais sexy do século XXI”.

Where it began

1662Londres, Inglaterra

O armarinho londrino John Graunt publicou 'Observações naturais e políticas... feitas sobre as contas de mortalidade', uma análise sistemática dos registros semanais de mortes paroquiais que Londres mantinha desde os anos da peste, a partir dos quais estimou a população da cidade e identificou padrões nas causas de morte. Foi uma das primeiras tentativas conhecidas de tirar conclusões gerais a partir de um grande conjunto de dados recolhidos, em vez de anedotas individuais, e rendeu a Graunt, um lojista sem formação universitária, a eleição para a Royal Society – a raiz intelectual à qual o nome do campo, muito mais tarde, acabaria por ser associado.

Timeline

1662Graunt analisa as contas de mortalidade de Londres

John Graunt publica um estudo estatístico dos registros de mortes nas paróquias de Londres, estimando o tamanho da população e os padrões de mortalidade - um dos primeiros usos sistemáticos de dados coletados para tirar conclusões gerais.

1908Gosset publica o teste t como 'Student'

William Sealy Gosset, estatístico da cervejaria Guinness em Dublin, publica “The Provable Error of a Mean” sob o pseudônimo de “Student” porque a Guinness proibiu os funcionários de publicarem sob seus próprios nomes, introduzindo a distribuição t usada na análise de pequenas amostras desde então.

1925Fisher publica 'Métodos Estatísticos para Pesquisadores'

Ronald Fisher, analisando décadas de dados de rendimento agrícola na Estação Experimental de Rothamsted, publica o livro que estabelece a análise de variância e o desenho experimental moderno como prática estatística padrão.

1933Neyman e Pearson formalizam testes de hipóteses

O artigo de Jerzy Neyman e Egon Pearson 'Sobre o problema dos testes mais eficientes de hipóteses estatísticas' fornece às estatísticas a sua estrutura moderna para decidir, com taxas de erro quantificadas, se um resultado é significativo.

1962Tukey argumenta que a análise de dados é uma ciência própria

O artigo de John Tukey 'O Futuro da Análise de Dados' argumenta que a análise de dados reais merece reconhecimento como uma ciência distinta com seus próprios métodos, e não um ramo menor da estatística matemática.

1977A 'Análise Exploratória de Dados' de Tukey populariza o box plot

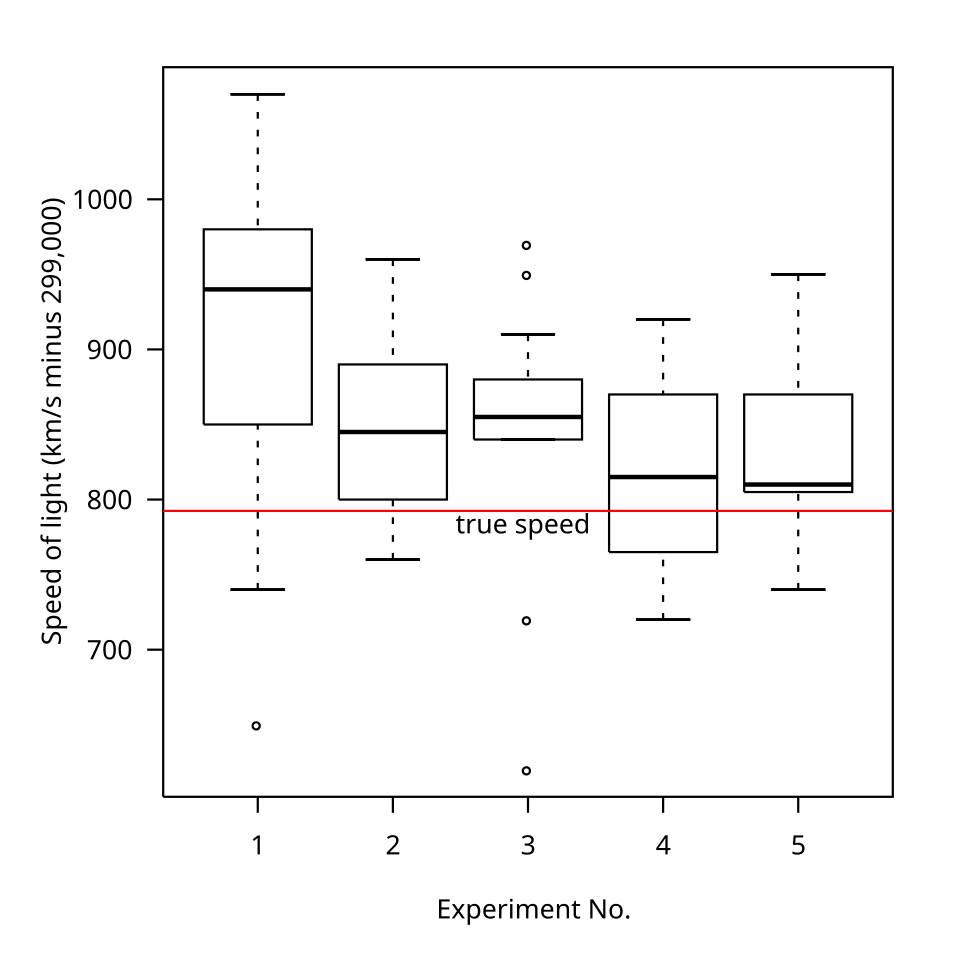
O livro de Tukey oferece aos profissionais ferramentas práticas - entre elas o box plot - para compreender a forma de um conjunto de dados a olho nu antes de ajustar qualquer modelo a ele.

1996Fayyad, Piatetsky-Shapiro e Smyth definem 'descoberta de conhecimento'

O artigo do trio na AI Magazine formaliza a 'descoberta de conhecimento em bancos de dados' como o processo mais amplo que envolve a mineração de dados brutos, parte de uma onda da década de 1990 de formalização da descoberta de padrões em bancos de dados corporativos em crescimento.

2001Cleveland propõe 'ciência de dados' como um campo

O estatístico do Bell Labs, William S. Cleveland, publica 'Ciência de Dados: Um Plano de Ação para Expandir as Áreas Técnicas do Campo de Estatística', propondo departamentos universitários dedicados à ciência de dados.

2008Patil e Hammerbacher cunharam o cargo

Construindo equipes de dados no LinkedIn e no Facebook, respectivamente, DJ Patil e Jeff Hammerbacher escolhem, de forma independente, “cientista de dados” como título para o trabalho de estatística e engenharia que suas equipes estavam realizando.

2012Harvard Business Review chama-lhe o ‘trabalho mais sexy’

O artigo de outubro de 2012 de Thomas Davenport e DJ Patil, “Cientista de dados: o trabalho mais sexy do século 21”, desencadeia um boom de contratações corporativas que dura há uma década e uma onda de novos programas de graduação universitária.

The eras

1662–1899

Contando os vivos e os mortos

Em 1662, o armarinho londrino John Graunt publicou uma análise estatística dos registros de óbitos paroquiais da cidade, uma das primeiras tentativas conhecidas de tirar conclusões gerais a partir de dados coletados, em vez de anedotas individuais. O astrônomo belga Adolphe Quetelet ampliou a ideia na década de 1830 com sua “física social”, aplicando distribuições estatísticas às características humanas. Florence Nightingale levou a tradição à persuasão prática em 1858, utilizando um diagrama da área polar dos dados de mortalidade da Guerra da Crimeia para convencer o Ministério da Guerra Britânico de que o mau saneamento, e não o combate, estava a matar a maioria dos soldados – tornando-se a primeira mulher eleita membro da Royal Statistical Society no processo.
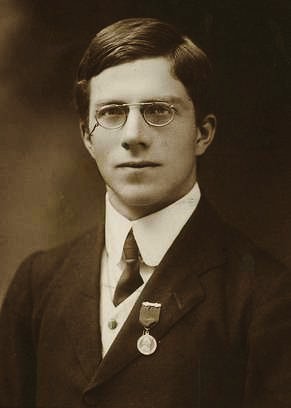
Fotografia de Ronald Fisher, cujos métodos estatísticos fundamentam a moderna ciência de dados
Unknown author Unknown author · Public domain · Wikimedia Commons
1900–1935

Estatísticos formalizam inferência

Karl Pearson fundou a revista Biometrika em 1901 para dar um lar à jovem disciplina de estatística matemática. William Sealy Gosset, que trabalhava como estatístico para a cervejaria Guinness, publicou o teste t em 1908 sob o pseudônimo de “Student” porque a Guinness proibia os funcionários de publicarem em seus próprios nomes. O livro de 1925 de Ronald Fisher, 'Métodos Estatísticos para Trabalhadores de Pesquisa', escrito durante a análise de décadas de testes de colheita na Estação Experimental de Rothamsted, introduziu a análise de variância e um projeto experimental rigoroso. Jerzy Neyman e Egon Pearson completaram o kit de ferramentas em 1933 com uma estrutura formal para testes de hipóteses – o maquinário estatístico que a ciência de dados mais tarde herdaria quase intacto.

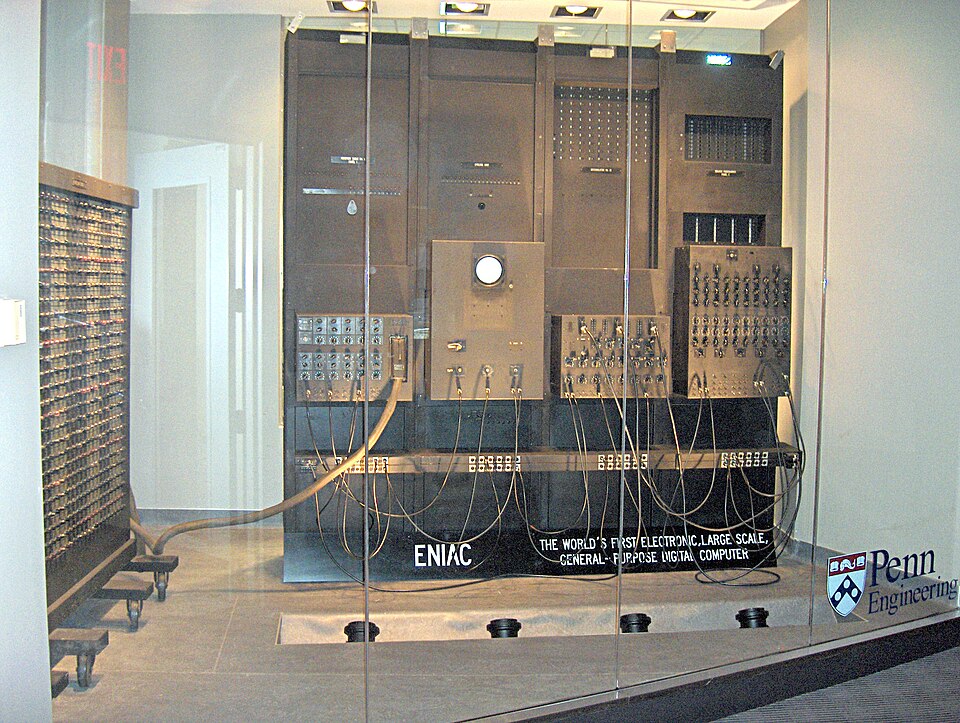
ENIAC, um dos primeiros computadores eletrônicos de uso geral, lançado em 1946
The original uploader was TexasDex at English Wikipedia . · CC BY-SA 3.0 · Wikimedia Commons
1936–1969

Os computadores chegam e Tukey apresenta um caso

A Segunda Guerra Mundial acelerou o cálculo em grande escala, desde equipas de computação humana até aos primeiros computadores electrónicos de uso geral, como o ENIAC, revelado em 1946. Os estatísticos que passaram décadas a fazer cálculos manuais utilizaram cada vez mais máquinas para executar análises numa escala anteriormente impossível. Em 1962, o estatístico John Tukey, dos Bell Labs e de Princeton, publicou “O Futuro da Análise de Dados”, argumentando que a análise de dados reais estava sendo “mal ensinada” como um ramo menor da estatística matemática e merecia reconhecimento como sua própria ciência, com seus próprios métodos e sua própria reivindicação de atenção das universidades.

Um box plot, uma das ferramentas exploratórias de análise de dados que John Tukey popularizou
User:Schutz · Public domain · Wikimedia Commons
1970–1999

Análise exploratória e o boom da mineração de dados

O livro de Tukey de 1977, 'Análise Exploratória de Dados', deu aos profissionais ferramentas práticas - entre elas o box plot - para compreender a forma de um conjunto de dados antes de ajustar qualquer modelo a ele. À medida que as empresas acumulavam bases de dados transacionais crescentes durante as décadas de 1980 e 1990, surgiu uma disciplina paralela de “mineração de dados” para encontrar padrões nelas; um artigo de 1996 de Usama Fayyad, Gregory Piatetsky-Shapiro e Padhraic Smyth formalizou a distinção entre a mineração de dados brutos e o processo mais amplo de 'descoberta de conhecimento em bancos de dados'. O armazenamento de dados corporativos, popularizado através dos escritos do consultor Bill Inmon ao longo da década, deu a este trabalho um lar permanente dentro de grandes empresas.

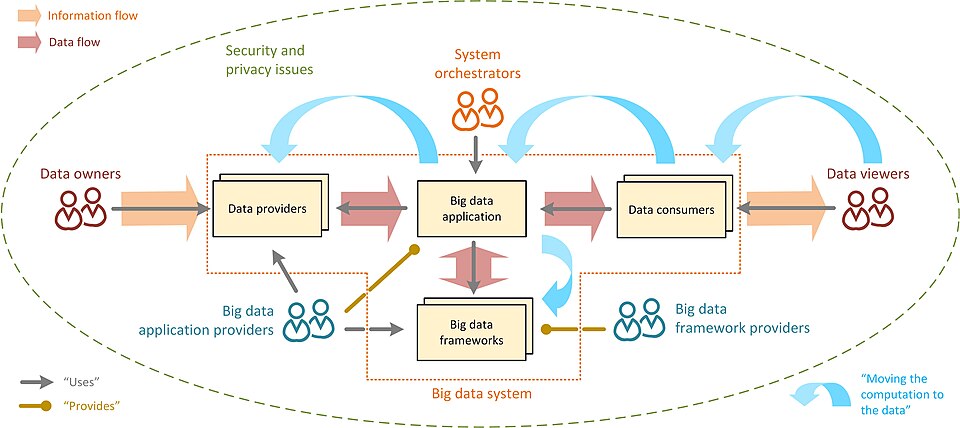
Ilustração conceitual de dados em grande escala, a matéria-prima da ciência de dados do século XXI
Jouasse · CC BY-SA 4.0 · Wikimedia Commons
2000 – presente

Nomeado, intitulado, sensacionalista e especializado

O estatístico do Bell Labs, William S. Cleveland, propôs 'ciência de dados' como o nome para uma disciplina estatística ampliada em um artigo de 2001. O artigo MapReduce do Google de 2004 e a estrutura de código aberto Hadoop que se seguiu forneceram ao campo ferramentas baratas para dados em escala de Internet. Por volta de 2008, DJ Patil e Jeff Hammerbacher, formando equipes de dados no LinkedIn e no Facebook, escolheram de forma independente “cientista de dados” como título de trabalho, e o artigo de Thomas Davenport e Patil de outubro de 2012 na Harvard Business Review chamando-o de “o trabalho mais sexy do século 21” desencadeou um boom de contratações corporativas que durou uma década. No final da década de 2010, a função amadureceu o suficiente para se dividir em títulos mais especializados – engenheiro analítico, engenheiro de aprendizado de máquina, analista de produto – mesmo quando a IA generativa começou a automatizar grande parte das consultas de rotina e traçar a descrição original do trabalho que uma pessoa faria manualmente.

What this job replaced

Neighbouring trades that no longer exist — absorbed, automated or regulated away.

Computador humano

Décadas de 1880 a 1950

Muito antes dos computadores eletrónicos, equipas de trabalhadores - desproporcionalmente mulheres, como os 'Harvard Computers' que catalogaram estrelas no Harvard College Observatory a partir da década de 1880, e Katherine Johnson, Dorothy Vaughan e Mary Jackson da NASA, que calcularam manualmente as trajetórias orbitais na década de 1960 - realizaram o trabalho matemático agora feito por software. Os computadores eletrônicos absorveram o papel dentro de uma geração de se tornarem confiáveis ​​e acessíveis.

Operador de cartão perfurado / perfurador

Décadas de 1890 a 1970

Seguindo o tabulador de cartões perfurados de Herman Hollerith, construído para o Censo dos EUA de 1890, os operadores de digitação passaram décadas transcrevendo registros em papel para cartões que os computadores mainframe pudessem ler, uma habilidade administrativa especializada ensinada em cursos de treinamento dedicados. Terminais de computador de entrada direta tornaram a função obsoleta nas décadas de 1970 e 1980.

Programador de relatórios em lote de mainframe

Décadas de 1960 a 2000

Os departamentos corporativos de “processamento de dados” já empregaram programadores, muitas vezes trabalhando em COBOL, cuja principal tarefa era escrever e executar trabalhos programados em lotes noturnos que produziam relatórios impressos da administração na manhã seguinte. Painéis de business intelligence de autoatendimento e ferramentas de consulta ad hoc permitem que os gerentes obtenham seus próprios números sob demanda, fechando essa especialidade quase totalmente na década de 2000.

Trades that vanished →

Cada capacidade que a ciência de dados afirma ser nova – descoberta de padrões em grandes conjuntos de dados, inferência rigorosa, visualização persuasiva – tem um ancestral específico e verificável: as tabelas de mortalidade de Graunt, os testes de colheita de Fisher, os box plots de Tukey. O que mudou em 2001 e 2008 foi principalmente o nome e a embalagem, aplicados a uma antiga nave recentemente alimentada por armazenamento e computação baratos.

O boom do “trabalho mais sexy” de 2012 que se seguiu já seguiu parcialmente o seu curso: o título dividiu-se em engenheiro analítico, engenheiro de aprendizagem automática e analista de produtos, e a IA generativa está a absorver a rotina de consultas e gráficos que a descrição original do trabalho de 2008 tinha como certa. A disciplina subjacente – decidir o que um padrão nos dados realmente significa – provavelmente durará mais uma vez mais que o cargo específico.

Similar professions

Continue exploring

Keep exploring

More in Science & Research